ตอนที่ 6: ทำไม Deep Learning ถึงได้รับความนิยมในปัจจุบัน? — เจาะลึก 3 ฟันเฟืองทองคำผู้ปลุกชีพสมองกลลึก
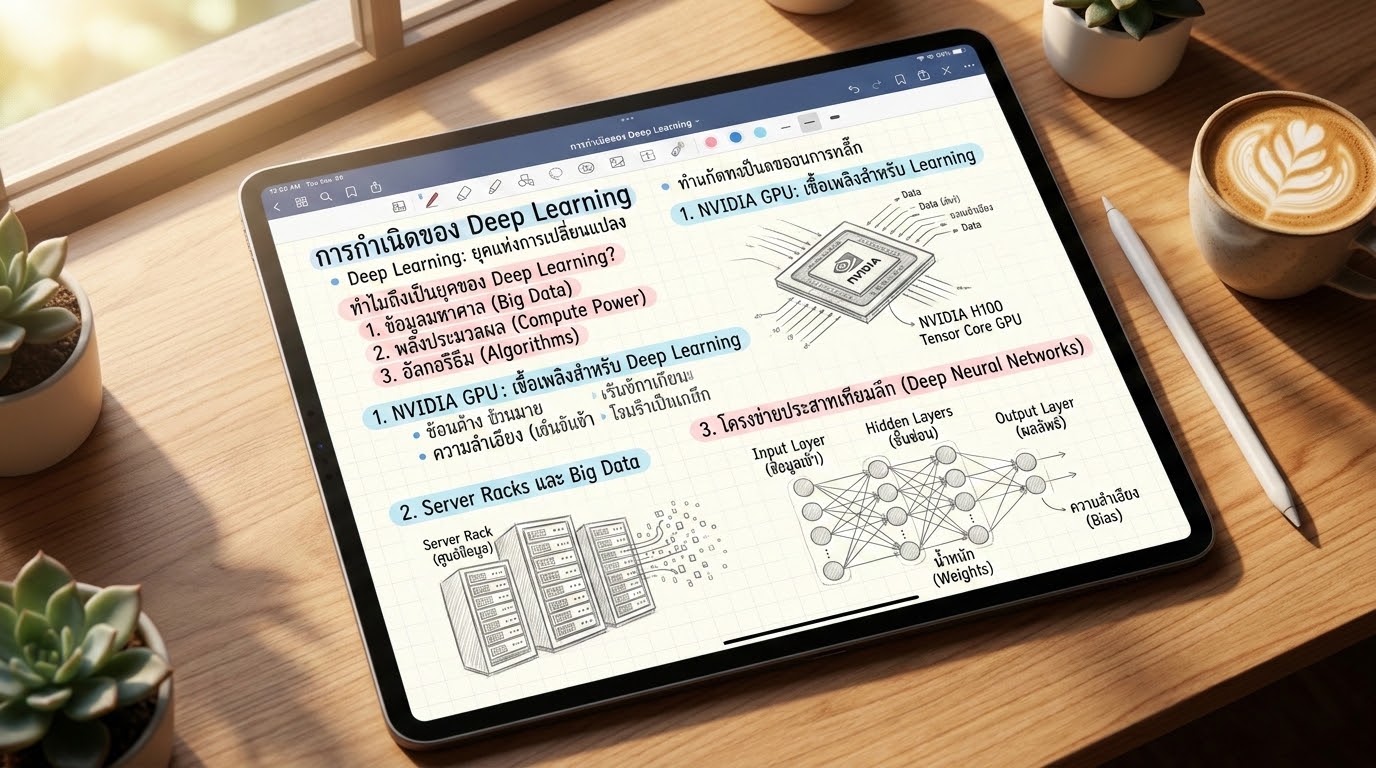
ย้อนกลับไปในช่วงต้นปี 2000 หากคุณเดินเข้าไปในสถาบันวิจัยคอมพิวเตอร์แล้วบอกว่า “ผมกำลังทำวิจัยเรื่องโครงข่ายประสาทเทียมหลายชั้นเลเยอร์ (Deep Neural Networks)” คุณคงได้รับการส่ายหน้าและคำแนะนำให้รีบเปลี่ยนหัวข้อวิจัยทันทีครับ เพราะในยุคนั้น แบบจำลองใยประสาทถูกตราหน้าว่าเป็นเครื่องมือที่ “ทั้งช้า เทรนยาก และให้ผลลัพธ์ที่ห่วยแตก” เมื่อเทียบกับพระเอกสุดหรูอย่าง Support Vector Machine (SVM)
แต่ตัดภาพมาในทศวรรษปัจจุบัน เทคโนโลยี Deep Learning (DL) กลับกลายเป็นฟันเฟืองหลักที่ขับเคลื่อนระบบขับขี่อัตโนมัติของรถยนต์อัจฉริยะ, แชตบอตภาษาขนาดใหญ่ (LLMs) ที่โต้ตอบได้อย่างเป็นธรรมชาติ, และระบบตรวจสอบหน้างานวิชันในโรงงานเป้าหมายระดับอุตสาหกรรม
อะไรคือสิ่งที่ทำให้เทคโนโลยีที่ครั้งหนึ่งเคยเกือบตายในยุค AI Winter กลับมาผงาดและยึดครองโลกไอทีได้อย่างรวดเร็วในชั่วข้ามคืน? วันนี้พี่วิศวกรอาวุโสจะมาชวนทุกคนจิบกาแฟสกัดแก่นแท้ของ “3 ปัจจัยทองคำ (Three Golden Factors)” ที่ปลดล็อกพลังของระบบเรียนรู้เชิงลึกนี้กันครับ!
🧠 ทฤษฎีและหลักการเบื้องหลัง (Theoretical Framework)
ความสำเร็จและอัตราการเติบโตแบบก้าวกระโดดของ Deep Learning ไม่ได้เกิดขึ้นจากโชคชะตา แต่เกิดจากการมาบรรจบกันอย่างสมบูรณ์แบบของฟันเฟืองหลัก 3 ประการดังนี้ครับ:
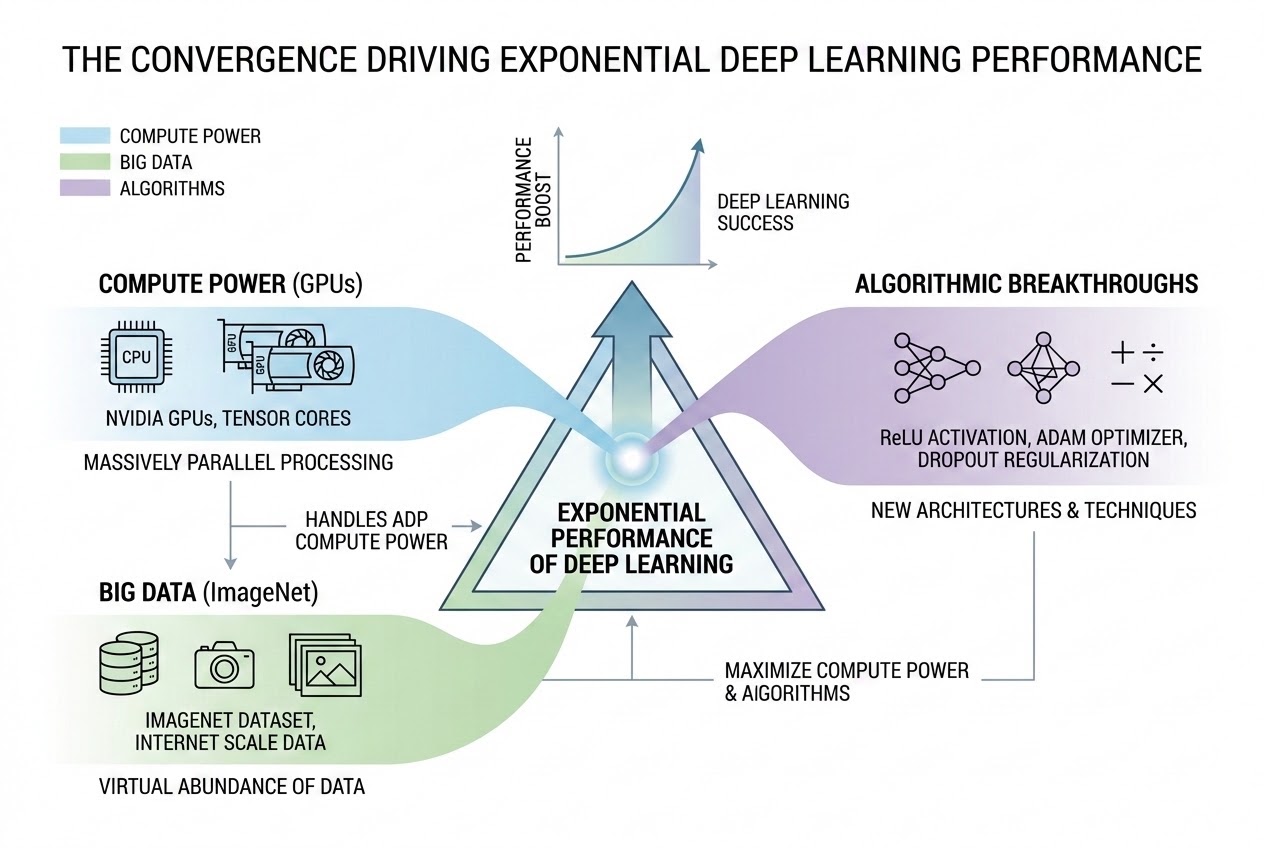
🏎️ 1. พลังประมวลผลที่สูงขึ้นอย่างไร้ขีดจำกัด (The Hardware Revolution)
โครงข่ายประสาทเทียมระดับลึกประกอบด้วยนิวรอนจำลองหลายร้อยล้านตัว การส่งข้อมูลไปข้างหน้า (Forward Pass) และการคำนวณย้อนกลับเพื่ออัปเดตน้ำหนักคณิตศาสตร์ (Backward Pass) แท้จริงแล้วคือกระบวนการ “คูณเมทริกซ์และพีชคณิตเชิงเส้น (Matrix Multiplication)” ขนาดยักษ์จำนวนหลายล้านล้านรอบ
- จาก CPU สู่ GPU (Graphics Processing Unit): คอมพิวเตอร์ดั้งเดิมใช้หน่วยประมวลผลกลาง (CPU) ที่ถูกออกแบบมาให้คำนวณงานที่ละขั้นตอนแบบเป็นลำดับเส้นตรงอย่างรวดเร็ว (Sequential Processing) ซึ่งไม่เหมาะกับการคูณเมทริกซ์ขนาดมหาศาล ในขณะที่ GPU (ที่แต่เดิมเราใช้เล่นเกมสามมิติ) ประกอบด้วยแกนประมวลผลย่อยๆ หลายพันคอร์ที่ทำงานขนานกันได้ (Massive Parallel Processing) ทำให้การเทรนโมเดลที่เคยใช้เวลาเป็นปีลดลงเหลือเพียงไม่กี่ชั่วโมง!
- การมาถึงของ ASIC จำเพาะอย่าง TPU (Tensor Processing Unit): ฮาร์ดแวร์พิเศษที่ถูกหล่อหลอมขึ้นมาเพื่อคำนวณเวกเตอร์คณิตศาสตร์ของ Deep Learning โดยเฉพาะ ยิ่งผลักดันขีดจำกัดความเร็วไปสู่ระดับจีแอปส์และเทราฟลอปส์
🗄️ 2. ยุคมหาข้อมูลไหลบ่าและคลัง ImageNet (Big Data & High-Quality Datasets)
โมเดลคลาสสิกของ Machine Learning (เช่น Linear Regression, Decision Tree) มีคุณลักษณะทางคณิตศาสตร์แบบระนาบเรียบง่าย ซึ่งจะมี “ขีดจำกัดของการพัฒนาประสิทธิภาพ” เมื่อเราป้อนข้อมูลดิบเข้าไปในจำนวนที่เยอะระดับหนึ่ง ประสิทธิภาพการเรียนรู้จะนิ่งเฉยและแบนราบลง (Performance Plateau)
ประสิทธิภาพโมเดล (Performance)
▲
│ ┌───────────────────────────────┐
│ │ Deep Learning (DL) │
│ ╱│ │
│ ╱ │ │
│ ╱ │ │
│ ╱ │ │
│ ───────────╱────┼───────────────────────────────┘
│ ┌──────────╱ │
│ │ Classical ML │
│ └────────────────┘
└────────────────────────────────────────►
ปริมาณข้อมูลดิบ (Amount of Data)- ข้อมูลคืออาหารของสมองกลลึก: ในทางกลับกัน Deep Learning ยิ่งได้รับปริมาณข้อมูลที่มากขึ้นเท่าไหร่ ประสิทธิภาพการสกัดฟีเจอร์เด่นผ่านเลเยอร์ซับซ้อนก็ยิ่งทะยานสูงขึ้นเป็นเส้นตรงอย่างสวยงาม
- ImageNet (2012): คลังภาพถ่ายเฉลยโดยมนุษย์กว่า 14 ล้านรูป ถูกพัฒนาขึ้นมาเพื่อเป็นสนามประลองขนาดใหญ่ที่ป้อนประสบการณ์เชิงลึกให้โมเดล AI เรียนรู้ลวดลายความแตกต่างในโลกแห่งความเป็นจริงจนเกิดการจดจำได้อย่างแม่นยำเหนือมนุษย์
🧮 3. การปฏิวัติอัลกอริทึมและโครงสร้างคณิตศาสตร์ (Algorithmic Advancements)
ในอดีต การซ้อนทับเลเยอร์ประสาทเทียมลึกๆ มักเจอกำแพงมรณะที่เรียกว่า Vanishing Gradient (ปัญหาการสูญเสียความชันเมื่อส่งสัญญาณย้อนกลับเพื่อหาค่าอนุพันธ์ ทำให้เลเยอร์แรกๆ ไม่ได้รับการปรับปรุง Weights เลย) นักวิจัยได้คิดค้นฟังก์ชันและการจัดสรรโครงสร้างแบบใหม่มาแก้ปัญหานี้:
- เปลี่ยนฟังก์ชันเปิดใช้งานเป็น ReLU (Rectified Linear Unit): อดีตนิยมใช้ฟังก์ชัน Sigmoid ที่บีบอัดข้อมูลให้อยู่ระหว่าง ($0$) ถึง ($1$) ซึ่งทำให้ค่าความชันเกือบเป็น ($0$) เมื่อโมเดลมีความลึก แต่เมื่อเปลี่ยนมาใช้ ReLU:
$$f(x) = \max(0, x)$$
ซึ่งให้ความชันคงตัวเป็น ($1$) เสมอเมื่อค่าข้อมูลเป็นบวก ปัญหาสัญญาณความชันหายจึงถูกขจัดไปโดยสิ้นเชิง!
- เทคนิคคุมเสถียรภาพและการปรับตัวอัจฉริยะ: นวัตกรรมอย่าง Dropout (การสุ่มปิดสวิตช์นิวรอนบางส่วนเพื่อป้องกันการจำข้อสอบ), Batch Normalization (การสเกลข้อมูลระหว่างทางเลเยอร์) และสถาปัตยกรรมปฏิวัติวงการอย่าง Convolutional Neural Network (CNN) และ Transformer ที่ช่วยให้การแปลงรูปภาพและข้อความภาษาเป็นระเบียบ ทรงประสิทธิภาพ และแข็งแกร่งยิ่งขึ้น
🛠️ ขั้นตอบการทดลองและติดตั้ง (Implementation Guide)
ในฐานะวิศวกรปัญญาประดิษฐ์ เรามาลองเขียนโค้ดภาษา Python ด้วย PyTorch เพื่อตรวจสอบสถานะฮาร์ดแวร์สลับอุปกรณ์ (Device Casting) ระหว่าง CPU และ GPU พร้อมสร้างโครงข่ายประสาทลึกที่ใช้งานฟังก์ชัน ReLU เพื่อพิสูจน์ระบบประมวลผลความเร็วสูงกันครับ:
import torch
import torch.nn as nn
import time
# 1. ตรวจสอบสถานะการเชื่อมต่อฮาร์ดแวร์ GPU (CUDA)
device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
print(f"--- 1. ฮาร์ดแวร์ที่ระบบเลือกใช้งาน: {device} ---")
# 2. จำลองสถาปัตยกรรมประสาทหลายเลเยอร์ (Deep Multi-Layer Perceptron)
class DeepBenchNet(nn.Module):
def __init__(self):
super(DeepBenchNet, self).__init__()
# ข้อมูลดิบ 1000 มิติ ผ่าน 5 เลเยอร์ลึกที่ใช้ฟังก์ชัน ReLU
self.network = nn.Sequential(
nn.Linear(1000, 2048),
nn.ReLU(), # ช่วยแก้ปม Vanishing Gradient
nn.Linear(2048, 2048),
nn.ReLU(),
nn.Linear(2048, 1024),
nn.ReLU(),
nn.Linear(1024, 10) # พ่นผลลัพธ์คำทำนาย 10 คลาส
)
def forward(self, x):
return self.network(x)
# 3. เตรียมข้อมูลและแบบจำลอง (ส่งไปประมวลผลที่ Hardware Device)
model = DeepBenchNet().to(device)
# จำลองดาต้าขนาดใหญ่ (10,000 แถว, 1000 คอลัมน์)
raw_features = torch.randn(10000, 1000).to(device)
# 4. ทดสอบความเร็วในการประมวลผลข้อมูลส่งผ่านระบบ (Forward Pass)
start_time = time.time()
with torch.no_grad():
predictions = model(raw_features)
end_time = time.time()
print("--- 2. สรุปผลการประมวลผลระดับวิศวกรรม ---")
print(f"มิติของพารามิเตอร์ทำนายปลายทาง: {predictions.shape}")
print(f"เวลาที่ใช้ในการคำนวณผ่านเครือข่ายลึก: {(end_time - start_time) * 1000:.4f} มิลลิวินาที")⚠️ ข้อควรระวังและแนวทางปฏิบัติที่ดีที่สุด (Pitfalls & Best Practices)
The Illusion of Need (หลุมพรางความโลภในเทคโนโลยีลึก): อย่าเพิ่งเหมารวมว่า “Deep Learning” คือคำตอบที่ดีที่สุดสำหรับทุกโปรเจกต์อุตสาหกรรมในสายงานผลิตของคุณครับ! หากข้อมูลหน้างานจริงเป็นข้อมูลแบบตารางขนาดเล็ก (ตารางพนักงาน, สถิติอุณหภูมิเครื่องจักรรายวัน) การฝืนใช้งานแบบจำลองประสาทเทียมขนาดใหญ่ไม่เพียงแต่ทำให้ระบบทำงานช้าและกินไฟ แต่ยังอาจให้ผลลัพธ์ที่ห่วยกว่าการเลือกใช้อัลกอริทึมสถิติคลาสสิกจาก Scikit-learn อีกด้วย
GPU Cache Cleanup (การจัดการขยะหน่วยความจำวิดีโอ):
เมื่อรันโมเดล Deep Learning บน GPU พึงระมัดระวังข้อผิดพลาด RuntimeError: CUDA out of memory ซึ่งเกิดจากการประจุอาร์กิวเมนต์ตัวแปรสะสมไว้ใน VRAM หากทำงานเสร็จสิ้นหรือสลับกระบวนการเทรน ควรล้างขยะระบบด้วยคำสั่ง torch.cuda.empty_cache() หรือปิดสคริปต์ก่อนรันรอบใหม่เสมอครับ
📝 บทสรุปและสเกลถัดไป (Conclusion & Next Steps)
ความนิยมของ Deep Learning ในวันนี้คือผลลัพธ์ของการที่ “เทคโนโลยีฮาร์ดแวร์และคลังข้อมูลวิ่งมาทันทฤษฎีคณิตศาสตร์ที่เคยถูกคิดค้นไว้เมื่อ 30 ปีก่อน” ครับ เมื่อพลังประมวลผลขนานของ GPU สอดประสานเข้ากับมวลมหาข้อมูลอุตสาหกรรม และสูตรคณิตศาสตร์ไร้ปมสูญเสียความชัน สมองกลลึกจึงสามารถปลดแอกขีดจำกัดการมองเห็นและการเรียนรู้ได้อย่างสมบูรณ์แบบ!
แต่ช้าก่อนครับ… ก่อนที่เราจะกระโจนไปถักทอโครงข่ายประสาทขนาดใหญ่นับล้านเลเยอร์ในวันเรียนจริง พรุ่งนี้คุณจำเป็นต้องก้าวผ่านประตูบานสำคัญที่สุดที่จะชี้วัดว่าคุณจะสร้างปัญญาประดิษฐ์ในทิศทางใด
เตรียมตัวมาทบทวนและติดตามกันต่อล่วงหน้าในบทความวิชาการตอนหน้า: “ตอนที่ 7: 3 เสาหลักของ Machine Learning — ถอดรหัสแผนผังการแบ่งแยกแนวทางการฝึกสอนปัญญาประดิษฐ์ตามโจทย์ธุรกิจ” คอยสแกนข้อมูลและจดคีย์เวิร์ดล่วงหน้ากันได้เลยครับ!