ตอนที่ 3: Deep Learning คืออะไร? — ถอดรหัสสถาปัตยกรรมสมองกลแบบหลายชั้นเลเยอร์
จินตนาการถึงคืนวันเสาร์ที่แสนเร่งด่วนในโรงงานประกอบชิ้นส่วนอิเล็กทรอนิกส์ มีเสียงโทรศัพท์ดังขึ้นจากไลน์ผลิต: “พี่ครับ! โมเดลตรวจจับตำหนิแผงวงจร (PCB) ที่เราใช้ Scikit-learn คัดแยกประเภทมันพังยับเยินเลยครับ เพราะบอร์ดรุ่นใหม่นี้มีการสลับเลย์เอาต์ลายวงจรสีเขียวอ่อนเขียวแก่ผสมกัน โมเดลสถิติแบบเดิมมันแยกแยะความแตกต่างไม่ออกเลย!”
นี่คือสถานการณ์คอขวดที่วิศวกรวิชันมักปวดหัวเมื่อใช้แบบจำลองคลาสสิก (Shallow Learning) ในการประมวลผลข้อมูลที่มีความซับซ้อนและไร้โครงสร้าง เช่น รูปภาพ แสงเงา หรือเสียง หากคุณต้องการแยกแยะสิ่งเหล่านี้ด้วยวิถีทางเดิม คุณต้องมานั่งทำ “Feature Engineering” ด้วยการคำนวณทิศทางขอบเงาเฉดสีด้วยมือทีละชิ้น ซึ่งเป็นกระบวนการที่กินแรงมหาศาลและพังง่ายมาก
ทางออกของปัญหานี้ไม่ใช่การปรับจูนสมการสถิติแบบเดิมครับ แต่มันคือการเปลี่ยนขั้วไปสู่ Deep Learning (การเรียนรู้เชิงลึก) ที่สามารถสร้างและสลับสับเปลี่ยนคุณลักษณะเด่น (Feature Learning) ขึ้นมาใช้งานเองโดยอัตโนมัติ วันนี้รุ่นพี่วิศวกร AI จะพามาไขความลับใต้กะโหลกสมองกลกันครับว่ามันทำงานอย่างไร!
🧠 ทฤษฎีและหลักการเบื้องหลัง (Theoretical Framework)
Deep Learning (DL) เป็นสาขาจำเพาะ (Subfield) ที่แตกแขนงออกมาจาก Machine Learning โดยมุ่งเน้นไปที่การสร้างและฝึกฝน โครงข่ายประสาทเทียมหลายชั้น (Deep Artificial Neural Networks) เพื่อทำหน้าที่เป็น “ตัวประมาณค่าฟังก์ชันคณิตศาสตร์สากล” (Universal Function Approximators) ในการจัดการกับความสัมพันธ์ของข้อมูลที่ทับซ้อนและไม่เป็นเส้นตรง (Non-linear)
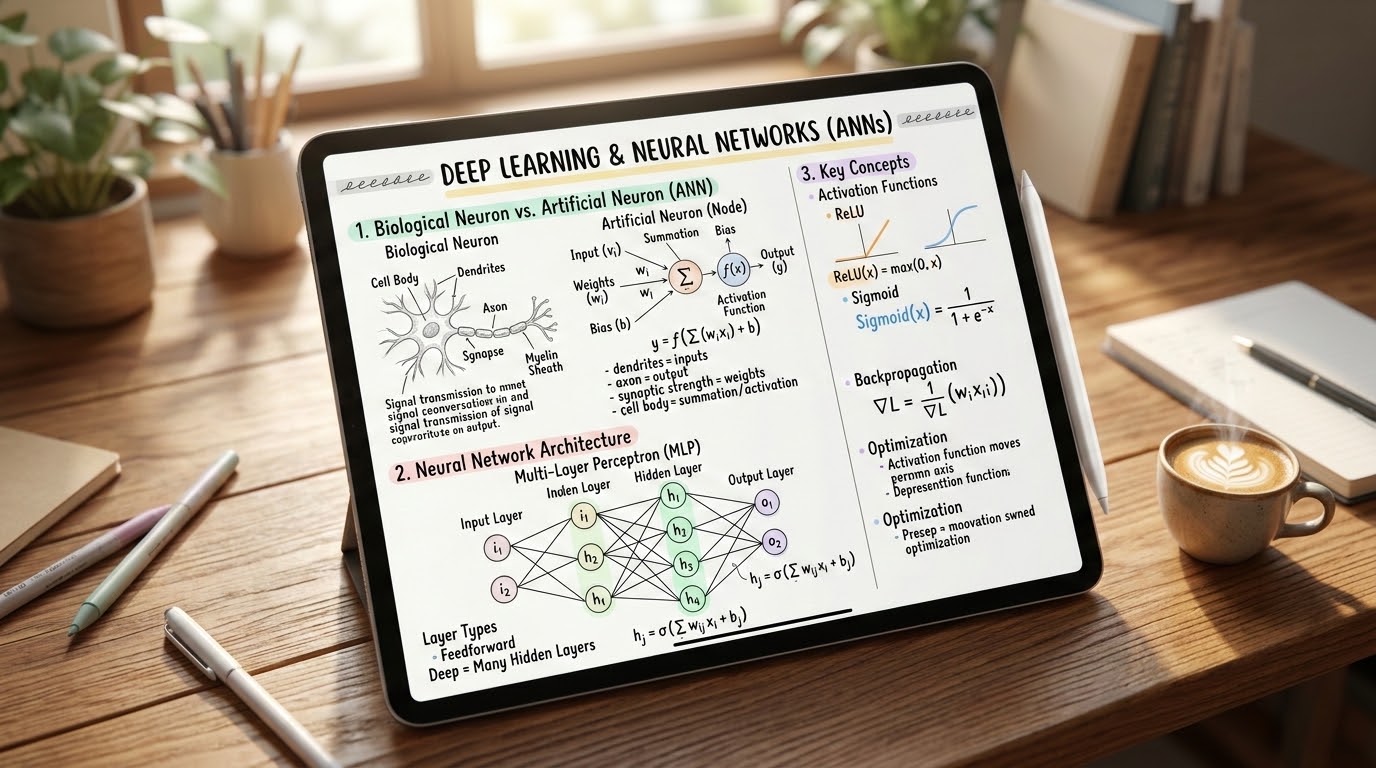
1. ความเชื่อมโยงและความแตกต่าง: นิวรอนชีววิทยา VS สมองกลคณิตศาสตร์
สถาปัตยกรรมของโครงข่ายประสาทเทียม (ANN) ได้รับแรงบันดาลใจเชิงลึกมาจากวิธีการสื่อสารของเซลล์ประสาทจริงในสมองของมนุษย์ โดยเราสามารถเปรียบเทียบส่วนประกอบต่างๆ ได้ดังนี้ครับ:
| เซลล์ประสาทมนุษย์ (Biological Neuron) | โครงข่ายประสาทเทียม (Artificial Neuron) | หน้าที่เชิงวิศวกรรมข้อมูล |
|---|---|---|
| Dendrites (ใยประสาทนำเข้า) | Input Signals (\(x_i\)) | ช่องทางรับกระแสไฟฟ้าหรือค่าข้อมูลตัวเลขป้อนเข้าระบบ |
| Synapses (จุดประสานประสาท) | Weights (\(w_i\)) | ค่าตัวแปรค่าน้ำหนักที่ปรับเปลี่ยนได้เพื่อคุมระดับความสำคัญของข้อมูล |
| Soma (ตัวเซลล์หลัก) | Net Input / Summation (\(\Sigma\)) | ส่วนคำนวณหาค่าเฉลี่ยถ่วงน้ำหนักรวมของข้อมูลดิบ |
| Axon (ใยประสาทนำออก) | Output / Activation Value (\(y\)) | ช่องทางส่งถ่ายสัญญาณที่ประมวลผลแล้วไปสู่จุดถัดไป |
หลุมพรางความเข้าใจผิด: มันไม่ใช่สมองมนุษย์ 100%! พึงระลึกไว้เสมอว่า แม้แนวคิดแรกเริ่มของปัญญาประดิษฐ์จะได้รับ “แรงบันดาลใจ” มาจากชีวประสาท (Neurobiology) แต่ระบบ Deep Learning ในปัจจุบันเป็น กรอบงานทางคณิตศาสตร์สถิติบริสุทธิ์ สมองมนุษย์มีความซับซ้อน มีการเชื่อมต่อแบบไร้ทิศทางคงตัว และมีวิวัฒนาการตลอดเวลา ขณะที่โมเดลของคอมพิวเตอร์ทำงานเป็นโครงสร้างเลเยอร์ที่มีระเบียบคงที่และถูกขับเคลื่อนผ่านการหาอนุพันธ์แคลคูลัส (Gradient Descent) เท่านั้นครับ
2. Anatomy of Neural Network: โครงสร้าง 3 ส่วนหลัก
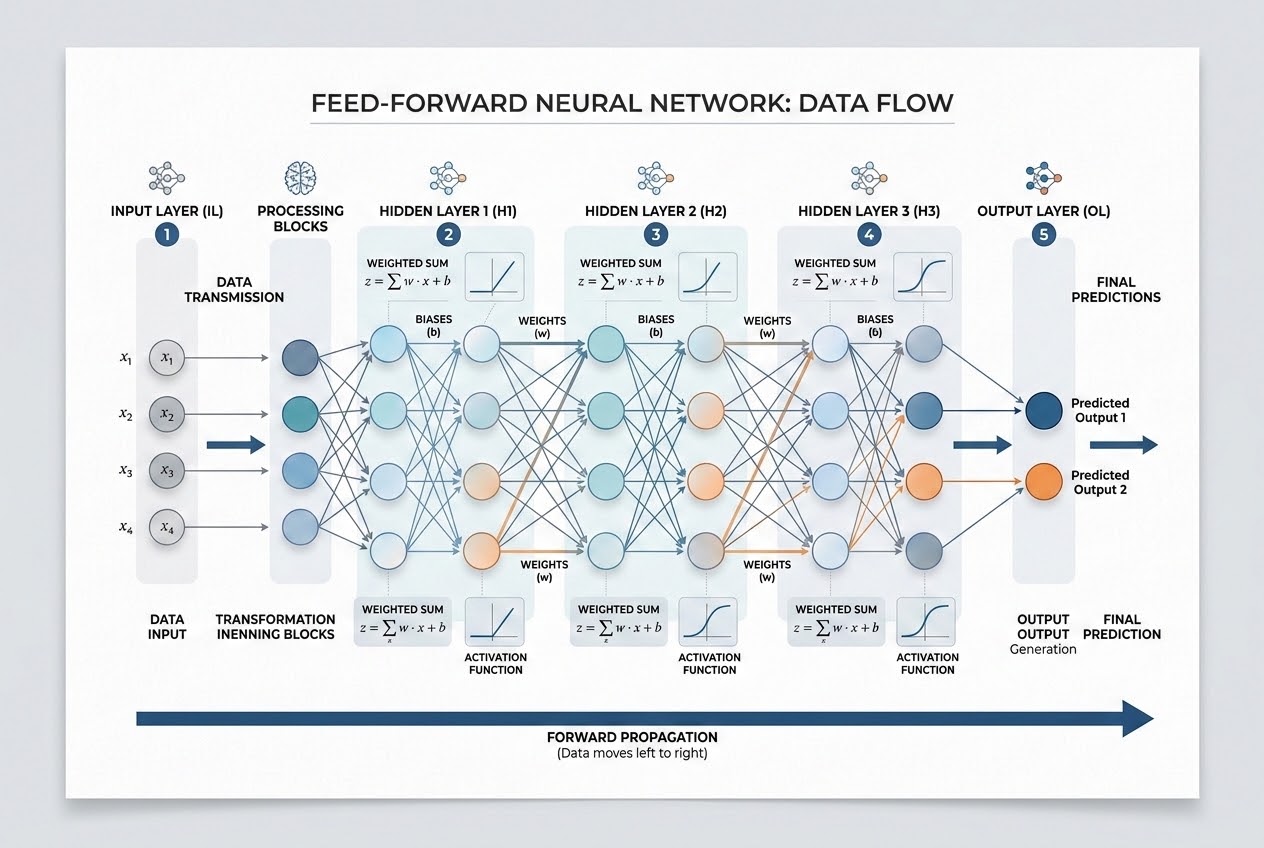
ระบบโครงข่ายประสาทเทียมจะเชื่อมโยงปมคำนวณย่อยๆ (Nodes) เอาไว้ด้วยกันผ่านรูปแบบเลเยอร์หลัก 3 ประเภท:
- Input Layer (เลเยอร์รับข้อมูล): ทำหน้าที่รับข้อมูลดิบป้อนเข้า (เช่น ค่าพิกเซลสีของรูปภาพ หรือเวกเตอร์คุณสมบัติ) โดยคอลัมน์ในข้อมูลดิบจะถูกจำลองเป็นโหนดเดี่ยวๆ ของเลเยอร์แรกนี้
- Hidden Layers (เลเยอร์ซ่อนเร้น): หัวใจหลักในการสกัดฟีเจอร์เด่น ซึ่งรวบแซนด์วิชอยู่ตรงกลางระหว่าง Input และ Output ยิ่งเลเยอร์ตรงกลางนี้มีจำนวนซ้อนทับกันมากเท่าไหร่ (ปกติมากกว่า 2 หรือ 3 ชั้นขึ้นไป) เราก็ยิ่งเรียกโมเดลนั้นว่ามีความ “ลึก (Deep)” มากเท่านั้น
- Output Layer (เลเยอร์พ่นผลลัพธ์): นำผลลัพธ์ที่คำนวณได้ชั้นสุดท้ายมาตีความออกมาเป็นคำทำนาย เช่น ความน่าจะเป็นที่จะเป็นหน้าแอปเปิลเกรดพรีเมียม (0.0 - 1.0)
3. กลไกการประมวลผลข้อมูลแบบลำดับขั้น (Hierarchical Representation Learning)
สิ่งที่ทำให้ Deep Learning โดดเด่นกว่าอัลกอริทึมทั่วไป คือ ความสามารถในการสลายโจทย์ซับซ้อนให้กลายเป็นคอนเซปต์ย่อยๆ แบบลำดับขั้น (Hierarchy of Abstraction) ผ่านเลเยอร์ต่างๆ ดังนี้:
[ข้อมูลภาพดิบ] ──> [เลเยอร์แรกสุด: ตรวจจับเส้นตัดและขอบเงา] ──> [เลเยอร์กลาง: ผนึกเส้นคู่ออกมาเป็นลวดลาย/รูปทรง] ──> [เลเยอร์ลึกสุด: รวมรูปทรงเป็นรูปหน้าตาแอปเปิลสำเร็จ]กระบวนการนี้ช่วยให้ระบบจดจำภาพวัตถุได้อย่างสมบูรณ์แบบโดยไม่ต้องพึ่งพามนุษย์มาช่วยกรองคุณลักษณะเด่นให้เลยครับ
🛠️ ขั้นตอนการทดลองและติดตั้ง (Implementation Guide)
เพื่อทดสอบแนวคิดนี้ในทางปฏิบัติ เราลองมาสร้างโมเดลโครงข่ายประสาทเทียมหลายชั้นเลเยอร์ (Multi-Layer Perceptron: MLP) สำหรับจำแนกประเภทข้อมูลรูปภาพหรือเวกเตอร์ขนาด 32 ฟีเจอร์ โดยใช้เฟรมเวิร์กมาตรฐานโลกอย่าง TensorFlow / Keras กันครับ:
import tensorflow as tf
from tensorflow.keras import layers, models
import numpy as np
# 1. จำลองข้อมูลดิบ (Inputs: 1000 ตัวอย่าง, ฟีเจอร์ 32 คอลัมน์)
X_train_data = np.random.random((1000, 32))
# เฉลยคำตอบจำนวน 10 คลาสสิกหมวดหมู่ (Multi-class targets)
y_train_labels = np.random.randint(10, size=(1000, 1))
# 2. ก่อสร้างสถาปัตยกรรมสมองกลแบบหลายเลเยอร์ (Deep Neural Network Architecture)
model = models.Sequential([
# เลเยอร์รับข้อมูล (Input Layer) คาดหวังอาเรย์ขนาด 32 ฟีเจอร์
layers.Input(shape=(32,)),
# เลเยอร์ซ่อนเร้นชั้นที่ 1 (First Hidden Layer): มี 64 นิวรอนจำลอง
# ใช้ฟังก์ชัน ReLU (Rectified Linear Unit) เพื่อเปลี่ยนความชันแบบไม่เป็นเส้นตรง
layers.Dense(64, activation='relu'),
# เลเยอร์ซ่อนเร้นชั้นที่ 2 (Second Hidden Layer): มี 64 นิวรอนจำลอง
layers.Dense(64, activation='relu'),
# เลเยอร์ส่งคำตอบสุดท้าย (Output Layer): มี 10 นิวรอน (สอดคล้องกับจำนวนคลาสที่จะทำนาย)
# ใช้ Softmax เพื่อแปลงค่าพลังงานดิบให้ออกมาเป็นเปอร์เซ็นต์ความน่าจะเป็นรวมเท่ากับ 100%
layers.Dense(10, activation='softmax')
])
# 3. กำหนดตัวควบคุมการเรียนรู้ (Optimizer) และตัววัดค่าสูญเสียความเอเรอร์ (Loss Function)
model.compile(
optimizer='adam', # อัลกอริทึมการปรับจูนค่าน้ำหนักอัจฉริยะ
loss='sparse_categorical_crossentropy', # วัดข้อผิดพลาดสำหรับ multi-class classification
metrics=['accuracy'] # ติดตามผลการเรียนรู้ด้วยคะแนนความแม่นยำ
)
# แสดงรายละเอียดสถาปัตยกรรมจำลอง
model.summary()
# 4. เริ่มต้นรันกระบวนการเรียนรู้อย่างเป็นทางการ (Training Loop)
print("\n--- เริ่มขั้นตอนส่งผ่านข้อมูลเพื่อประมวลผลและอัปเดตค่าน้ำหนัก ---")
model.fit(X_train_data, y_train_labels, epochs=5, batch_size=32)⚠️ ข้อควรระวังและแนวทางปฏิบัติที่ดีที่สุด (Pitfalls & Best Practices)
The Heavy Computation Bottleneck (คอขวดพลังงานประมวลผล): โครงข่ายประสาทแบบลึกที่มีพารามิเตอร์นับล้านตัว ต้องอาศัยเครื่องมือช่วยประมวลผลแบบขนานความเร็วสูงอย่างกราฟิกการ์ด (GPUs หรือ TPUs) เพื่อสางสมการ forward และ backward pass หากนำไปรันบน CPU ทั่วไปในคอมพิวเตอร์สำนักงาน โมเดลของคุณอาจจะใช้เวลาเทรนนานเป็นสัปดาห์จนระบบแฮงก์ได้ครับ!
Data Hunger (วิกฤติความอดอยากข้อมูล): Deep Learning จะทรงพลังและฉลาดได้ ก็ต่อเมื่อมันได้รับ “ข้อมูลดิบจำนวนมหาศาล” หากคุณมีชุดข้อมูลตัวอย่างที่น้อยกว่าหลักพันรายการ การเลือกใช้โมเดลคลาสสิกทางสถิติของ Scikit-learn (เช่น GBDT, Random Forest, หรือ SVM) จะทำงานได้คล่องตัว แม่นยำ และปลอดภัยกว่าการใช้ Deep Net ขนาดใหญ่อย่างมหาศาลครับ
📝 บทสรุปและสเกลถัดไป (Conclusion & Next Steps)
สรุปสั้นๆ คือ Deep Learning ก็คือศาสตร์ในการถักทอสมการคณิตศาสตร์ย่อยๆ (นิวรอน) ในรูปของเลเยอร์ทับซ้อนกันเพื่อสางปมปัญหาในโลกแห่งข้อมูลที่เปลี่ยนไปตามสภาพแวดล้อมจริง ยิ่งเลเยอร์มีความลึกมาก มันก็ยิ่งจัดการกับตัวแปรที่พึ่งพาอาศัยกันได้อย่างชาญฉลาดและลื่นไหลโดยที่คุณไม่ต้องเสียเวลามาสกัดฟีเจอร์ด้วยตัวเองเลยครับ
ในตอนถัดไป เราจะข้ามพรมแดนจากเรื่องทฤษฎีพื้นฐาน มุ่งหน้าไปสู่วิศวกรรมคอมพิวเตอร์วิชันสายแข็งอย่าง “ตอนที่ 4: ความสัมพันธ์ระหว่าง AI, ML และ DL” คอยติดตามอ่านกันล่วงหน้าได้เลยครับ!