ตอนที่ 8: ทำความรู้จัก Data ในโลกของ ML — ถอดรหัสวัตถุดิบทองคำหลักของระบบสมองกล
ในค่ำคืนที่สายการผลิตรถยนต์ไฟฟ้ากำลังเดินหน้าอย่างเต็มสูบ จู่ๆ ระบบวิเคราะห์คุณภาพสีตัวถังรถยนต์อัตโนมัติก็เกิดหยุดชะงักและแจ้งเตือนความผิดพลาดสีเพี้ยนรัวๆ ทั้งที่ระบบเพิ่งได้รับการอัปเกรดไปใช้โมเดล Deep Learning โครงสร้างยักษ์ใหญ่ที่ราคาแพงระยับ!
เมื่อวิศวกรวิชันรีบวิ่งไปเปิดคอมพิวเตอร์ตรวจสอบโค้ดเพื่อหาจุดบั๊ก กลับพบว่าตัวอัลกอริทึมทำงานได้อย่างถูกต้อง ราบรื่น และไม่มีการแฮงก์ใดๆ แต่ต้นตอของโศกนาฏกรรมครั้งนี้มาจาก "ฝุ่นละอองและรอยคราบน้ำมันที่กระเซ็นไปเกาะหน้าเลนส์กล้องส่งถ่ายภาพ" ทำให้ภาพตัวถังรถยนต์สีขาวที่ส่งเข้าไปในระบบกลายเป็นภาพสีนวลอมเหลืองมัวๆ ส่งผลให้โมเดลประมวลผลผิดพลาดจนหยุดไลน์ผลิตไปกว่า 2 ชั่วโมง
เหตุการณ์คลาสสิกหน้างานจริงนี้สะท้อนสัจธรรมสูงสุดในโลกของปัญญาประดิษฐ์ที่ว่า "หากปราศจากข้อมูลที่มีคุณภาพ แม้แต่โมเดลที่อัจฉริยะที่สุดในปฐพีก็เป็นได้เพียงแค่ขยะทางคณิตศาสตร์" หรือที่เรามักเรียกทับศัพท์กันว่า Garbage In, Garbage Out วันนี้พี่วิศวกร AI จะมาพาน้องๆ นั่งจิบกาแฟสบายๆ แล้วมาถอดรหัสทำความเข้าใจประเภทของ Data (ข้อมูลดิบ) วัตถุดิบทองคำที่ใช้ฝึกสอนสมองกลให้เฉียบคมกันครับ!
🧠 ทฤษฎีและหลักการเบื้องหลัง (Theoretical Framework)
ในวิชาคณิตศาสตร์และวิศวกรรมข้อมูล ข้อมูลหนึ่งหน่วยตัวอย่างในจักรวาลของการเรียนรู้จะถูกนิยามให้เป็นสมาชิกของสเปซคุณลักษณะ โดยระบุเป็นสัญลักษณ์คณิตศาสตร์คือ:
$$ x \in \mathcal{X} $$
โดยที่ $\mathcal{X}$ คือ Instance Space (สเปซอินสแตนซ์) หรือกลุ่มรูปแบบข้อมูลที่เป็นไปได้ทั้งหมดในโลก และชุดข้อมูลฝึกสอน (Dataset) ของเราคือกลุ่มของอินสแตนซ์เหล่านี้ที่ถูกสุ่มตัวอย่างออกมาใช้งานจริงเพื่อเป็นประสบการณ์สอนเครื่อง
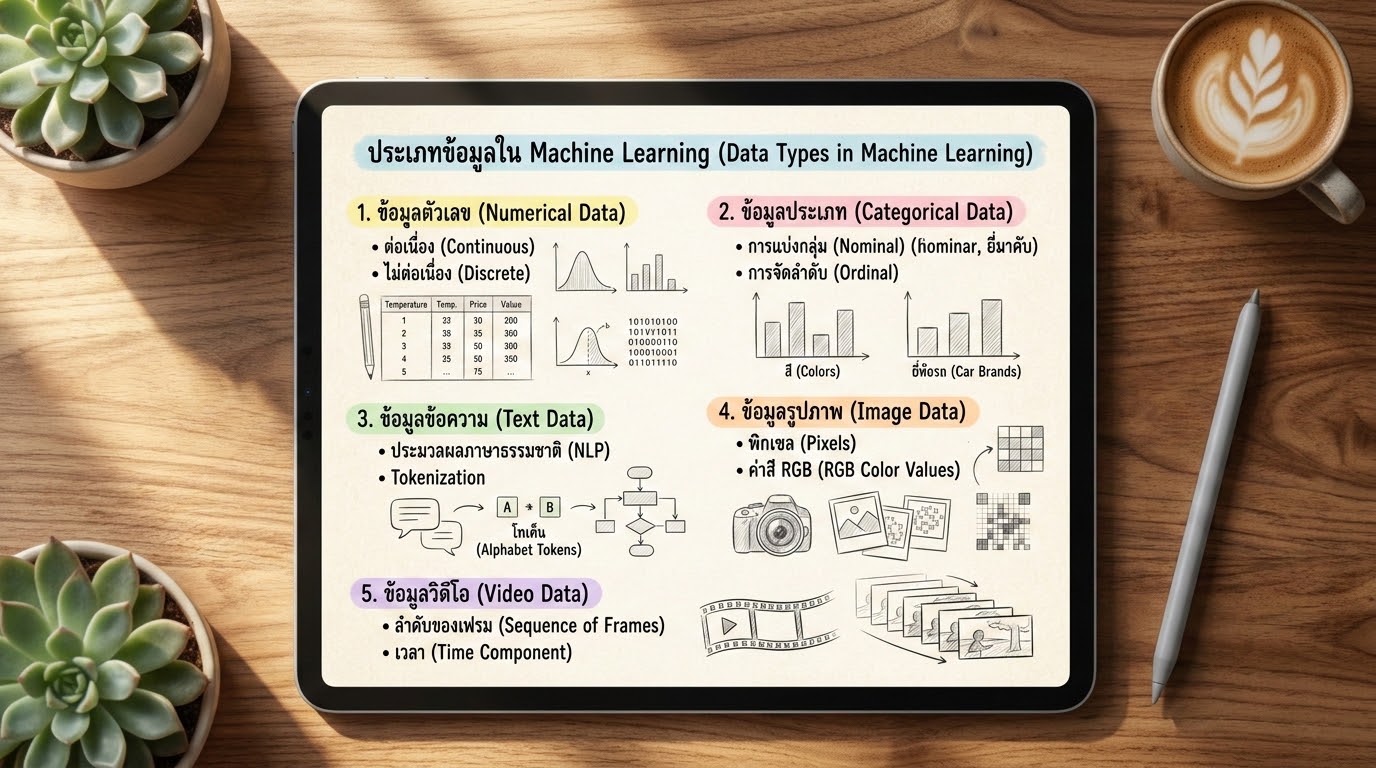
แต่เนื่องจากข้อมูลดิบในโลกแห่งความจริงไม่ได้เดินทางมาในรูปแบบตัวเลขที่พร้อมคำนวณเสมอไป เราสามารถจัดกลุ่มและจำแนกประเภทข้อมูลในมุมมองของ Machine Learning ออกเป็น 4 กลุ่มหลักๆ ตามความซับซ้อนของโครงสร้างได้ดังนี้ครับ:
1. Numerical Data (ข้อมูลเชิงตัวเลข)
เป็นข้อมูลที่ง่ายและเป็นมิตรกับคอมพิวเตอร์มากที่สุด เนื่องจากระบบคอมพิวเตอร์ทำงานและคำนวณทางพีชคณิตเชิงเส้นอยู่ตลอดเวลา ข้อมูลเชิงตัวเลขแบ่งออกเป็น 2 หมวดหมู่ย่อย:
- Continuous Data (ข้อมูลแบบต่อเนื่อง): ค่าข้อมูลที่สามารถเป็นทศนิยมและวัดค่าได้อย่างละเอียดไม่มีที่สิ้นสุด เช่น อุณหภูมิเตาหลอมคาร์บอน $25.4^\circ\text{C}$ หรือ $25.452^\circ\text{C}$, น้ำหนักสิ่งของ หรือความเร็วรอบมอเตอร์
- Discrete Data (ข้อมูลแบบไม่ต่อเนื่อง/จำนวนนับ): ค่าข้อมูลที่เป็นจำนวนเต็มที่ชัดเจน ไม่สามารถแบ่งท่อนเป็นทศนิยมที่มีความหมายได้ เช่น จำนวนชิ้นงานเสียในถาดคัดแยก $5$ ชิ้น (ไม่มี $5.3$ ชิ้น), จำนวนพนักงาน หรือจำนวนไลน์ผลิต
2. Categorical Data (ข้อมูลเชิงกลุ่มหรือหมวดหมู่)
ข้อมูลที่เป็นข้อความหรือตัวอักษรระบุประเภท คุณสมบัติ หรือหมวดหมู่ ซึ่งโมเดลคณิตศาสตร์จะ "คำนวณตรงๆ ไม่ได้" ต้องแปลงเป็นตัวเลขก่อนเสมอ แบ่งออกเป็น:
- Nominal Data (เชิงกลุ่มไม่มีลำดับ): ข้อมูลที่ไม่มีลำดับความสำคัญก่อนหลังหรือเปรียบเทียบค่าความสูงต่ำกันไม่ได้ เช่น เพศ (ชาย, หญิง), สีชิ้นงาน (แดง, น้ำเงิน, เขียว) หรือสถานะการผลิต (พักเครื่อง, เดินเครื่อง)
- Ordinal Data (เชิงกลุ่มแบบมีลำดับ): ข้อมูลที่มีระดับความสำคัญหรือระดับที่สามารถจัดอันดับเปรียบเทียบได้ เช่น เกรดของแอปเปิล (Premium > Medium > Regular) หรือระดับความพึงพอใจของลูกค้า (ดีมาก > ปานกลาง > ปรับปรุง)
3. Text Data (ข้อมูลข้อความ / ข้อมูลไม่มีโครงสร้างเชิงภาษา)
หนึ่งในข้อมูลที่ไร้ระเบียบ (Unstructured Data) ที่คลาสสิกที่สุด เช่น อีเมลร้องเรียนของลูกค้า, รายงานการซ่อมบำรุงของช่างเทคนิค หรือรีวิวสินค้า
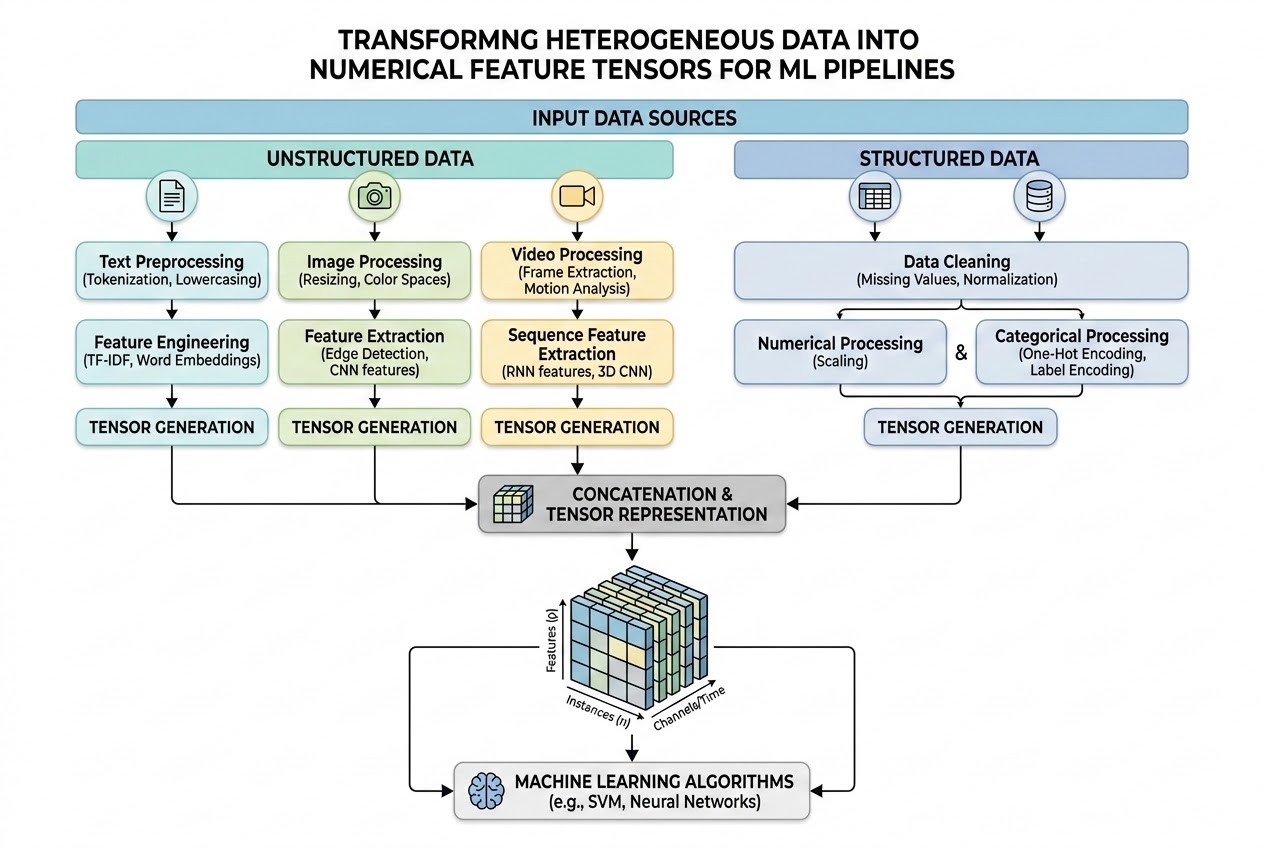
- การแปลงข้อมูล (Vectorization): เนื่องจากเครื่องไม่เข้าใจคำว่า "ชำรุด" หรือ "ดีมาก" นักวิจัยจึงต้องใช้เทคนิควิศวกรรมภาษาเพื่อแปลงข้อความเหล่านี้ให้กลายเป็นเวกเตอร์ตัวเลข (Numerical Tensors) ไม่ว่าจะเป็นวิธีดั้งเดิมอย่าง Bag-of-Words (BoW), TF-IDF หรือวิธีล้ำสมัยอย่าง Word Embeddings และ Tokenization ในโมเดลภาษาขนาดใหญ่ (LLMs) เพื่อรักษาความหมายและความเชื่อมโยงของภาษาไว้
4. Image & Video Data (ข้อมูลรูปภาพและวิดีโอ)
นี่คือหัวใจหลักของระบบวิชันอุตสาหกรรม (Machine Vision) และ Deep Learning:
- Image Representation (โครงสร้างรูปภาพ): ในสายตาของคอมพิวเตอร์ รูปภาพคือตารางตัวเลข (Matrix) ขนาดใหญ่ หากเป็นภาพขาวดำ (Grayscale) จะถูกมองเป็นตาราง 2 มิติขนาด $H \times W$ (ความสูงคูณความกว้าง) โดยแต่ละช่องมีค่าพิกเซลระหว่าง $0$ (ดำสนิท) ถึง $255$ (ขาวสนิท) แต่หากเป็นภาพสี (RGB) จะกลายเป็นสเปซ 3 มิติ (3D Tensor) ขนาด $H \times W \times C$ โดยที่ $C = 3$ แชนเนลสี (แดง, เขียว, น้ำเงิน)
- Video Representation (โครงสร้างวิดีโอ): วิดีโอคือ "อนุกรมเวลาของรูปภาพ" (Sequence of Images) ที่ร้อยเรียงกันตามเวลา โดยจะถูกแปลงเป็นเทนเซอร์ 4 มิติ (4D Tensor) ขนาด $F \times H \times W \times C$ โดยที่ $F$ คือจำนวนเฟรมรูปภาพต่อวินาที
🛠️ ขั้นตอนการทดลองและติดตั้ง (Implementation Guide)
ในฐานะสถาปนิกปัญญาประดิษฐ์ เราลองมาเปิดโปรแกรมเขียนโค้ด Python เพื่อจำลองและส่องประเภทข้อมูลหลากหลายแบบ (Numerical, Categorical, และ Image Matrix) ด้วยไลบรารี Pandas และ NumPy เพื่อเตรียมวิเคราะห์ข้อมูลก่อนส่งต่อไปเทรนโมเดลกันครับ:
import numpy as np
import pandas as pd
# =====================================================================
# 1. การจัดการข้อมูล Structured (Numerical & Categorical) ด้วย Pandas
# =====================================================================
# จำลองตารางประวัติการตรวจสอบคุณภาพชิ้นงานในโรงงาน
factory_data = {
'Machine_Temp': [85.5, 92.1, 78.4, 110.2, 88.0], # Continuous Numerical
'Error_Count':, # Discrete Numerical
'Shift_Type': ['Day', 'Night', 'Day', 'Night', 'Day'], # Nominal Categorical
'Quality_Grade': ['A', 'B', 'A', 'F', 'A'] # Ordinal Categorical
}
df = pd.DataFrame(factory_data)
print("--- 1. แสดงผลตารางข้อมูลตรวจสอบเครื่องจักร ---")
print(df)
# ตรวจสอบประเภทข้อมูลทางเทคนิคของ Pandas
print("\n--- 2. แสดงชนิดประเภทข้อมูลของแต่ละคอลัมน์ (Data Types) ---")
print(df.dtypes)
# =====================================================================
# 2. การแปลงข้อมูลตัวอักษรให้กลายเป็นตัวเลข (One-Hot Encoding)
# =====================================================================
# แปลง Nominal Data ('Shift_Type') ให้เป็นตัวเลข 0 และ 1
df_encoded = pd.get_dummies(df, columns=['Shift_Type'], drop_first=True)
print("\n--- 3. ตารางข้อมูลหลังแปลงตัวอักษรหมวดหมู่เป็น 0 และ 1 ---")
print(df_encoded)
# =====================================================================
# 3. การจำลองโครงสร้างข้อมูลรูปภาพ (Image) ด้วย NumPy
# =====================================================================
# จำลองรูปภาพขนาดเล็ก 3x3 พิกเซลแบบขาวดำ (Grayscale Image Matrix)
mock_image = np.array([
, # สีขาวกึ่งกลางดำมืด
,
], dtype=np.uint8)
print("\n--- 4. พิกัดตารางตัวเลขหลังม่านรูปภาพขนาด 3x3 พิกเซล ---")
print(mock_image)
print(f"มิติรูปภาพ (Shape): {mock_image.shape} | ชนิดตัวแปรหน่วยความจำ: {mock_image.dtype}")⚠️ ข้อควรระวังและแนวทางปฏิบัติที่ดีที่สุด (Pitfalls & Best Practices)
The Danger of Corrupted Data (อันตรายจากการปะปนของข้อมูลชำรุด): หนึ่งในจุดพังพินาศคลาสสิกของมือใหม่คือ การไม่ทำความสะอาดข้อมูลประเภทตัวเลขที่มีความบิดเบี้ยวผิดธรรมชาติ (Outliers) หรือการปะปนของข้อมูลว่างเปล่า (NaN/Null) ตัวแปรสถิติของโมเดลจะพยายามโอนเอนเข้าไปคำนวณค่าน้ำหนักเพื่อตอบรับค่าเพี้ยนเหล่านี้ ส่งผลให้สูตรทำนายเสียเสถียรภาพ ดังนั้นทุกครั้งก่อนเทรนโมเดล คุณต้องทำขั้นตอน EDA (Exploratory Data Analysis) เสมอครับ
The Scale Mismatch Problem (ปัญหาหน่วยวัดข้อมูลไม่สอดคล้องกัน): หากคุณป้อนข้อมูลเชิงตัวเลขที่มีหน่วยขนาดตัวเลขห่างชั้นกันมากๆ เช่น คอลัมน์ "อุณหภูมิรอบเครื่อง" (มีค่าระหว่าง 30 ถึง 100) ปะปนไปกับคอลัมน์ "แรงดันไฟฟ้ากิโลวัตต์" (มีค่าระหว่าง 10,000 ถึง 50,000) โมเดลแมชชีนเลิร์นนิงจะมองว่าแรงดันไฟฟ้ามีความสำคัญเหนือกว่าอุณหภูมิอย่างมหาศาลเนื่องจากขนาดเลขที่ใหญ่กว่า ทางออกที่ดีที่สุดคือต้องทำ Feature Scaling (เช่น Min-Max Scaling หรือ Standardization) ก่อนเทรนโมเดลเสมอครับ
📝 บทสรุปและสเกลถัดไป (Conclusion & Next Steps)
สรุปอย่างเฉียบคมคือ "ข้อมูล (Data) คือกระจกเงาสะท้อนความจริงในโลกฟิสิกส์ให้ออกมาอยู่ในหน้าต่างคณิตศาสตร์ที่คอมพิวเตอร์มองเห็นได้" ไม่ว่าข้อมูลนั้นจะเดินทางมาในรูปแบบตัวเลข ตารางสี หรือภาพพิกเซล งานหลักของวิศวกรปัญญาประดิษฐ์คือการเปลี่ยนรูปสัญญาณเหล่านี้ให้กลายเป็นระเบียบ คลีน และอยู่ในมาตรวัดสากลที่เหมาะสมแก่การย่อยของสมองกลครับ
แต่ในตารางข้อมูลดิบที่เราป้อนเข้าไปเพื่อฝึกสมองกลนั้น มีคำศัพท์เชิงกลยุทธ์สำคัญอีกสองคำที่เป็นตัวกำหนด "โครงสร้างและบทบาทหลัก" ในการนำทางให้อัลกอริทึมเรียนรู้ได้อย่างถูกทิศทาง
เตรียมตัวมาวิเคราะห์และติดตามอ่านต่อล่วงหน้าในตอนถัดไป: "ตอนที่ 9: Features และ Labels คืออะไร? — เปิดความลับพิกัดคำทำนายและตัวแปรนำทางในโลกแห่งสถิติเรียนรู้" คอยบันทึกคีย์เวิร์ดล่วงหน้ากันไว้ได้เลยครับ!