ตอนที่ 11: 3 นิกายแห่งมหาอาณาจักร Machine Learning — เลือกวิถีการเรียนรู้ให้สอดรับกับสเปกโจทย์ธุรกิจ
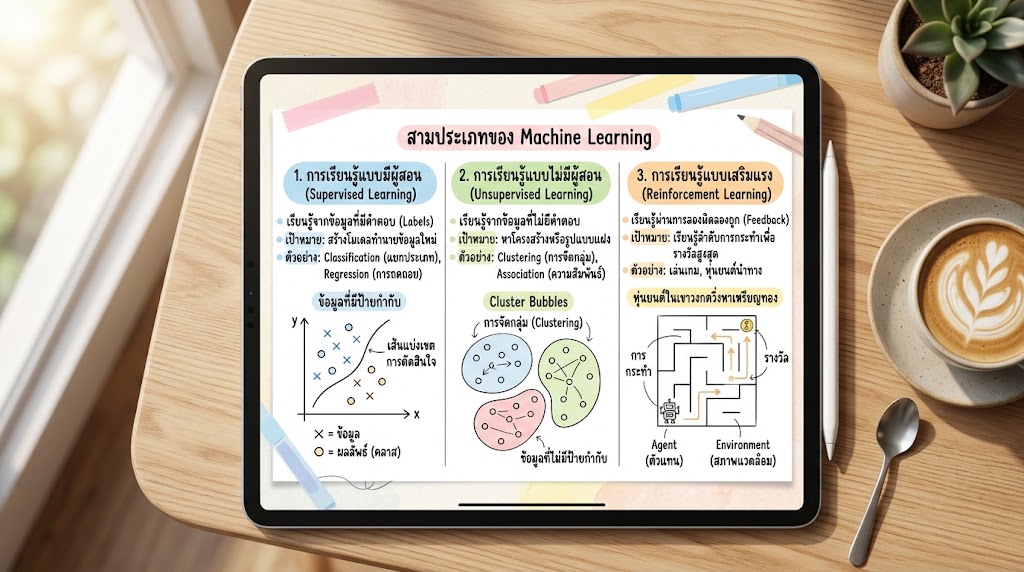
ในสายพานการทำงานจริงของโรงงานผลิตอัจฉริยะ วันหนึ่งคุณอาจจะพบกับปัญหา 3 รูปแบบที่แตกต่างกันโดยสิ้นเชิงดังนี้ครับ:
- โจทย์ข้อที่หนึ่ง: ช่างเครื่องต้องการระบุว่าตลับลูกปืนตัวนี้ชำรุดหรือไม่ โดยเรามีประวัติการบันทึกอุณหภูมิย้อนหลัง 3 ปี พร้อมป้ายบอกกำกับไว้ชัดเจนว่ารอบไหนรอด รอบไหนพัง
- โจทย์ข้อที่สอง: ฝ่ายซ่อมบำรุงต้องการตรวจหา “พฤติกรรมผิดปกติลึกลับ” ของมอเตอร์ต้นกำลังขนาดใหญ่ โดยเรามีเพียงข้อมูลสัญญาณแรงสั่นสะเทือนแบบเรียลไทม์ แต่ไม่มีใครเคยทำเฉลย (Labels) ไว้เลยว่าหน้าตาแรงสั่นสะเทือนแบบไหนคือวิกฤติพังพินาศ
- โจทย์ข้อที่สาม: แผนกโลจิสติกส์ต้องการให้หุ่นยนต์หยิบจับพัสดุ (Robotic Picking Arm) เรียนรู้วิธีการหมุนและหยิบสิ่งของแปลกใหม่ในลังด้วยตนเอง โดยไม่ต้องมีวิศวกรมานั่ง Hardcode เขียนโปรแกรมสั่งมุมพิกัดทุกองศา
หากคุณพยายามใช้ “สูตรทางคณิตศาสตร์แบบเดียว” มาแก้ปัญญาทั้งสามข้อนี้ โครงการพัฒนา AI ของโรงงานคุณคงล้มพับไปตั้งแต่สัปดาห์แรกครับ เพราะสถาปัตยกรรมเหล่านี้ตั้งอยู่บนพื้นฐานของทฤษฎีการเรียนรู้คนละแบบ
วันนี้รุ่นพี่ Senior AI Engineer จะพามาจิบกาแฟอุ่นๆ แล้วเปิดคัมภีร์พาส่อง “3 นิกายหลัก (Three Main Paradigms)” ที่แบ่งแยกแนวทางการฝึกฝนคอมพิวเตอร์ตามธรรมชาติของข้อมูลและเงื่อนไขทางวิศวกรรม เพื่อให้น้องๆ เลือกหยิบจับดาบและศาสตราจารย์ที่ถูกต้องไปฟันโจทย์จริงกันครับ!
🧠 ทฤษฎีและหลักการเบื้องหลัง (Theoretical Framework)
ในเชิงวิทยาศาสตร์ข้อมูลและการเรียนรู้เชิงลึก อนุกรมการเรียนรู้ของเครื่องจะถูกแบ่งประเภทตามโครงสร้างของข้อมูลดิบ และรูปแบบของ “สัญญาณป้อนกลับ (Feedback Signal)” ที่ป้อนให้แก่อัลกอริทึม โดยสกัดออกมาเป็น 3 แกนหลักสากลดังนี้ครับ:
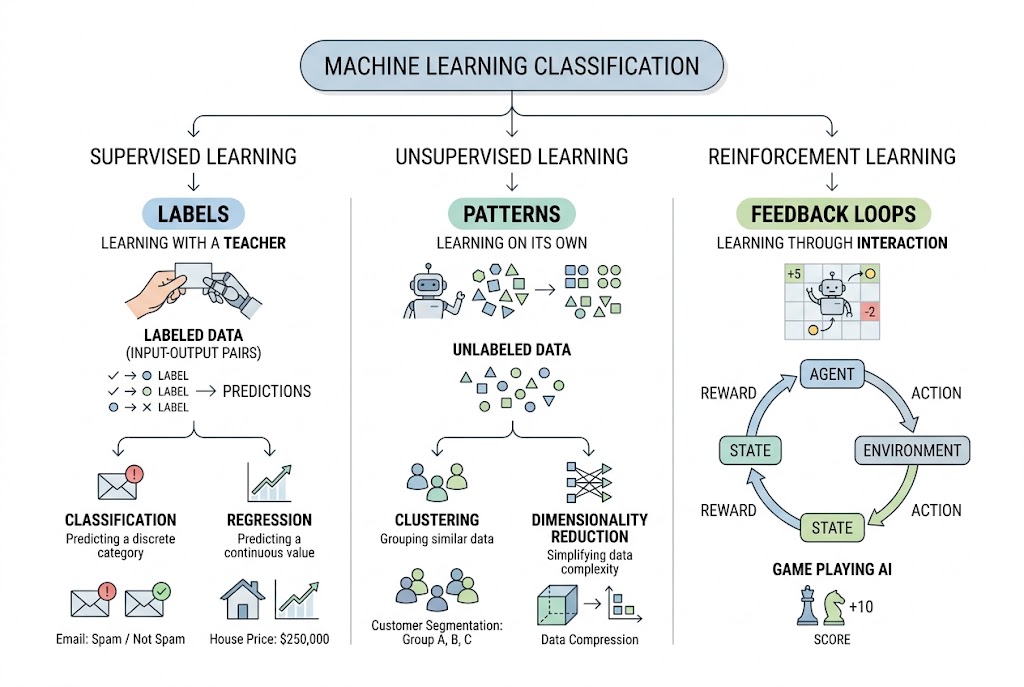
1. Supervised Learning (การเรียนรู้แบบมีผู้สอน) — การเรียนรู้ผ่านป้ายเฉลย
นี่คือวิถีที่ได้รับความนิยมและมีการใช้งานสูงที่สุดในโลกธุรกิจปัจจุบัน (คิดเป็นสัดส่วนมากกว่า 80% ของโซลูชัน AI ในอุตสาหกรรม)
- แก่นแท้ทางคณิตศาสตร์: ข้อมูลดิบที่ป้อนเข้าสู่กระบวนการเรียนรู้จะประกอบด้วยคู่ลำดับคุณลักษณะเด่นและเฉลยคำตอบปลายทางที่ชัดเจนเสมอ:
$$ S = {(\mathbf{x}_1, y_1), (\mathbf{x}_2, y_2), \dots, (\mathbf{x}_m, y_m)} $$
เป้าหมายสูงสุดคือการฝึกให้สมองกลค้นหาและเรียนรู้ฟังก์ชันคาดเดา $h(\mathbf{x})$ เพื่อแมปคุณลักษณะต้นทางไปหาป้ายเฉลยได้อย่างมีประสิทธิภาพสูงสุด โดยค่าความคลาดเคลื่อนจะถูกประเมินผ่านฟังก์ชันสูญเสีย (Loss Function) และอัปเดตโมเดลย้อนกลับเพื่อปรับปรุงคะแนน
- คำอุปมาอุปไมย (Analogy): เปรียบเสมือนนักเรียนที่กำลังนั่งอ่านหนังสือคู่มือเตรียมสอบที่มี “เฉลยคำตอบท้ายบท” กำกับไว้อย่างครบถ้วน ทุกครั้งที่นักเรียนตอบคำถามผิด ครูผู้สอนจะคอยตีมือและบอกคำตอบที่ถูกเพื่อให้จดจำแพทเทิร์นไปทำข้อสอบจริง
- โจทย์ธุรกิจคลาสสิก: การทำนายราคาสินค้าเชิงอุตสาหกรรม (Regression) และการตรวจจับคัดแยกเกรดแผงวงจรชำรุด (Classification)
2. Unsupervised Learning (การเรียนรู้แบบไม่มีผู้สอน) — การเรียนรู้ผ่านการสังเกตโครงสร้าง
ในโลกแห่งความเป็นจริง การทำป้ายเฉลย (Data Labeling) เป็นกระบวนการที่สิ้นเปลืองงบประมาณ เวลา และกำลังแรงงานมนุษย์มหาศาล บ่อยครั้งเราจึงต้องปล่อยให้เครื่องจักรประมวลผลข้อมูลที่ไม่มีเฉลย
- แก่นแท้ทางคณิตศาสตร์: ชุดข้อมูลฝึกสอนจะมีเพียงแค่เวกเตอร์คุณลักษณะเด่น $\mathbf{x}$ แต่ปราศจากป้ายเฉลย $y$ ปลายทาง:
$$ S = {\mathbf{x}_1, \mathbf{x}_2, \dots, \mathbf{x}_m} $$
หน้าที่หลักของอัลกอริทึมคือ การคำนวณหาความหนาแน่น ระยะห่างทางคณิตศาสตร์ (เช่น Euclidean Distance) หรือโครงสร้างการกระจายตัวของข้อมูล เพื่อจัดกลุ่มหรือลดทอนมิติข้อมูลให้ดูง่ายขึ้น
- คำอุปมาอุปไมย (Analogy): เปรียบเสมือนช่างเทคนิคที่ได้รับพัสดุอะไหล่เครื่องจักรชิ้นส่วนแปลกๆ มาเป็นกองยักษ์ 1,000 ชิ้นโดยไม่มีป้ายบอกชื่อรุ่น ช่างคนนี้จะต้องคัดแยกอะไหล่ด้วยการสังเกต ขนาด สี น้ำหนัก และรูปทรงฟิสิกส์ภายนอก แล้วจัดวางอะไหล่ที่มีหน้าตาคล้ายๆ กันให้อยู่ในกลุ่มกองเดียวกันเองอัตโนมัติ
- โจทย์ธุรกิจคลาสสิก: การจำแนกประเภทกลุ่มลูกค้าเป้าหมาย (Customer Clustering) และการตรวจจับสัญญาณสั่นสะเทือนมอเตอร์ที่ผิดแผกไปจากกลุ่มปกติ (Anomaly Detection)
3. Reinforcement Learning (การเรียนรู้แบบเสริมกำลัง) — การเรียนรู้ผ่านคะแนนรางวัล
เป็นศาสตร์ที่แตกต่างจากสองแบบแรกโดยสิ้นเชิง เนื่องจากระบบไม่ได้เรียนรู้จากชุดข้อมูลที่ถูกบันทึกไว้ในอดีต (Static Dataset) แต่เรียนรู้จากการเข้าทำปฏิกิริยากับสิ่งแวดล้อมที่เปลี่ยนแปลงแบบเรียลไทม์ (Dynamic Environment)
- แก่นแท้ทางคณิตศาสตร์: ขับเคลื่อนผ่านทฤษฎี Markov Decision Process (MDP) โดยมีตัวแทนระบบเรียกว่า Agent (ผู้กระทำ) อาศัยอยู่ในสถานะสภาพแวดล้อม State ($s_t$) และต้องตัดสินใจเลือกทำพฤติกรรม Action ($a_t$) ส่งผลให้สภาพแวดล้อมขยับเปลี่ยนไปสู่สถานะใหม่ $s_{t+1}$ พร้อมกับพ่นสัญญาณป้อนกลับที่เป็นแต้มคะแนนลบหรือบวกเรียกว่า Reward ($r_t$) กลับคืนมา:
$$ r_t \in \mathbb{R} $$
เป้าหมายสูงสุดของ Agent คือการเรียนรู้เพื่อหาทิศทางนโยบายการตัดสินใจ (Policy $\pi$) ที่สร้างผลรวมคะแนนรางวัลสะสมในระยะยาวสูงสุด (Expected Cumulative Reward)
- คำอุปมาอุปไมย (Analogy): เปรียบเหมือนการพยายามฝึกสอนสุนัขแสนรู้ด้วยการให้ขนมรางวัล หากมันยอมนั่งลงเมื่อได้รับสัญญาณคำสั่ง มันจะได้รับป้อนขนมแสนอร่อย (Positive Reward) แต่หากมันดึงดันวิ่งไปคาบรองเท้าของคุณไปกัดเล่น มันจะโดนดุและอดกินขนม (Negative Punishment)
- โจทย์ธุรกิจคลาสสิก: ระบบนำทางรถลำเลียงสินค้าอัตโนมัติในคลังสินค้า (AGV Grid Navigation) และการปรับจูนควบคุมระบบปรับอากาศส่วนกลางของเซิร์ฟเวอร์โรงงานขนาดใหญ่เพื่อประหยัดไฟ
🛠️ ขั้นตอนการทดลองและติดตั้ง (Implementation Guide)
เพื่อสลักแนวคิดนี้ลงสู่รหัสโปรแกรม ในเวิร์กช็อปของคุณพรุ่งนี้ คุณจะได้ทดลองจับประเด็นโครงสร้างโค้ดการประยุกต์ใช้งาน Scikit-learn เพื่อเปรียบเทียบแนวทางเขียนโครงสร้างระหว่าง Supervised (Decision Tree) และ Unsupervised (K-Means) ในไฟล์วิเคราะห์ข้อมูลดิบตัวเดียวกันดังนี้ครับ:
import numpy as np
from sklearn.tree import DecisionTreeClassifier
from sklearn.cluster import KMeans
# =====================================================================
# เตรียมข้อมูลจำลองสถิติไลน์ผลิต (Vibration, Temperature)
# =====================================================================
# Features Matrix (X): [อัตราสั่นสะเทือน (G), อุณหภูมิการทำงาน (C)]
X_factory_data = np.array([
[1.2, 45.0], [1.5, 48.0], [4.5, 85.0],
[1.1, 44.0], [4.8, 90.0], [1.3, 46.0]
])
# Labels สำหรับสาย Supervised (y): 1 = ตรวจผ่านเกณฑ์, 0 = ชำรุดพังเสียหาย
y_historical_labels = np.array([1, 1, 0, 1, 0, 1])
# =====================================================================
# 🟢 รูปแบบที่ 1: วิถี Supervised Learning (Decision Tree Classifier)
# มีข้อมูล Features (X) และป้ายเฉลย Labels (y) ส่งไปรันสร้างสมองคาดคะเน
# =====================================================================
supervised_model = DecisionTreeClassifier(random_state=42)
supervised_model.fit(X_factory_data, y_historical_labels) # ฝึกฝนสมการพร้อมเฉลย
# ลองทำนายชิ้นงานใหม่ที่ไม่เคยเห็นตอนเรียน
new_sample = np.array([[4.2, 82.0]])
predicted_class = supervised_model.predict(new_sample)
# =====================================================================
# 🔵 รูปแบบที่ 2: วิถี Unsupervised Learning (K-Means Clustering)
# มีเพียงชุดข้อมูล Features (X) ปราศจากป้ายเฉลย ให้เครื่องหาทางจับกุมกลุ่มเอง
# =====================================================================
# สั่งจัดวางข้อมูลเป็น 2 กลุ่มความเหมาะสม (K=2)
unsupervised_model = KMeans(n_clusters=2, random_state=42, n_init=10)
unsupervised_model.fit(X_factory_data) # ฝึกฝนโดยปราศจากป้ายเฉลย y!
# ตรวจสอบการพิกัดกลุ่มที่เครื่องปักป้ายจัดกลุ่มให้เอง
discovered_clusters = unsupervised_model.labels_
# =====================================================================
# 🔍 สรุปเปรียบเทียบผลลัพธ์
# =====================================================================
print("--- 1. วิถีประเมินคำตอบ Supervised (Decision Tree) ---")
print(f"ชิ้นงานตัวอย่างใหม่มีพฤติกรรมสั่นสะเทือนสูง ทำนายเกรดชิ้นงาน: {predicted_class}")
print("\n--- 2. วิถีสังเคราะห์กลุ่ม Unsupervised (K-Means Clustering) ---")
print("รหัสกลุ่มคลัสเตอร์ที่เครื่องแอบคำนวณและแยกให้ด้วยตนเอง:")
for idx, data in enumerate(X_factory_data):
print(f"ชิ้นงานที่ {idx+1} {data} -> เครื่องจัดอยู่ในกลุ่มหมายเลข: {discovered_clusters[idx]}")⚠️ ข้อควรระวังและแนวทางปฏิบัติที่ดีที่สุด (Pitfalls & Best Practices)
The Reinforcement Learning Over-kill (หลุมพรางความหรูหราของ RL): หลีกเลี่ยงกระบวนการ Over-engineering โดยใช้ระบบ Reinforcement Learning (RL) กับปัญหาทางธุรกิจที่จริงๆ แล้วแก้ได้เรียบง่ายด้วยโมเดลสถิติ Supervised ทั่วไปครับ! แม้ว่า RL จะดูทันสมัยและฉลาดมาก แต่การประกอบสิ่งแวดล้อมจำลอง (Simulation) และการตั้งแต้มรางวัลให้เสถียรต้องอาศัยขั้นตอนคณิตศาสตร์ที่ยุ่งยาก ซับซ้อน และโมเดลมีโอกาสเกิดการบิดเบี้ยวได้ง่ายกว่ามากครับ
The Crucial Rule of Data Sufficiency (กฎสัดส่วนคุณภาพของวัตถุดิบ): พึงระลึกไว้เสมอว่า การเลือกประเภทการเรียนรู้ต้องตั้งมั่นจากทรัพยากรข้อมูลที่คุณมีจริงหน้างาน หากในระบบไลน์ผลิตจริงไม่มีทีมวิศวกรคอยบันทึกเหตุการณ์พังของระบบเก็บไว้เลย การเลือกใช้โมเดลประเภท Unsupervised หรือ Semi-supervised เพื่อค้นหาจุดผิดปกติด้วยวิธีการวัดระยะทางสถิติ จะเป็นทางเลือกที่ส่งมอบผลงานได้ไวกว่าการดึงดันพยายามทำระบบ Supervised ครับ
📝 บทสรุปและสเกลถัดไป (Conclusion & Next Steps)
การเข้าใจถึงจุดเด่น ข้อจำกัด และโครงสร้างสถิติของทั้ง Supervised, Unsupervised และ Reinforcement Learning ช่วยให้น้องสวมหมวกเป็นสถาปนิกปัญญาประดิษฐ์ที่มองเห็นภาพกว้างของหน้างานได้อย่างเป็นวิศวกรรมสากล สามารถเปลี่ยนแนวทางวิจัยและเลือกอาวุธที่คุ้มค่า คล่องตัว และประหยัดงบประมาณอุตสาหกรรมที่สุดได้ครับ
ในบรรดาสามนิกายหลักนี้ วิถีที่ทรงพลังและพร้อมส่งมอบผลลัพธ์ธุรกิจคืนกลับมาได้เด่นชัดและรวดเร็วที่สุดคือ Supervised Learning (การเรียนรู้แบบมีผู้สอน)
เตรียมตัวมาทบทวนและลุยไปพร้อมๆ กันในตอนหน้า: “ตอนที่ 12: Supervised Learning (การเรียนรู้แบบมีผู้สอน) — ถอดสูตรถดถอยสมการเส้นตรงและโมเดลจำแนกประเภทชิ้นงานระดับคลาสสิก” ห้ามพลาดบทเรียนด่านประจัญบานแรกในเวิร์กช็อปเช้าวันพรุ่งนี้ด้วยความยินดีเป็นอย่างยิ่งครับวิศวกรรุ่นน้อง!