ตอนที่ 10: Training vs. Testing — ศิลปะการจัดแบ่งชุดข้อมูลเพื่อสยบภัยเงียบการท่องจำของสมองกล
ลองจินตนาการถึงคืนวันอาทิตย์ที่แสนเหนื่อยล้าในห้องปฏิบัติการนวัตกรรม คุณเพิ่งเทรนโมเดลตรวจจับ “ขวดพลาสติกมีรอยแตกร้าว” เสร็จสมบูรณ์ หน้าจอคอมพิวเตอร์พ่นค่าความแม่นยำออกมาอย่างน่ามหัศจรรย์: “Accuracy: 100%!” ทีมวิศวกรทุกคนในไลน์ต่างกระโดดดีใจและนำแบบจำลองนี้อัปโหลดขึ้นกล้องตรวจสอบบนสายพานผลิตจริงทันที
แต่เมื่อสายพานเริ่มเดินเครื่อง… ทันใดนั้นขวดร้าวขวดเบี้ยวกลับวิ่งหลุดรอดผ่านกล้องสแกนไปเฉย ๆ ราวกับว่าระบบปัญญาประดิษฐ์นี้ตาบอด! ค่าความถูกต้องแม่นยำ 100% ที่พ่นออกมาในห้องทดลองอันตรธานหายไปทันที เหลือทิ้งไว้เพียงอัตราการหลุดรอดของชิ้นงานเสียหายที่สูงถึง 40% ในสายผลิตจริง
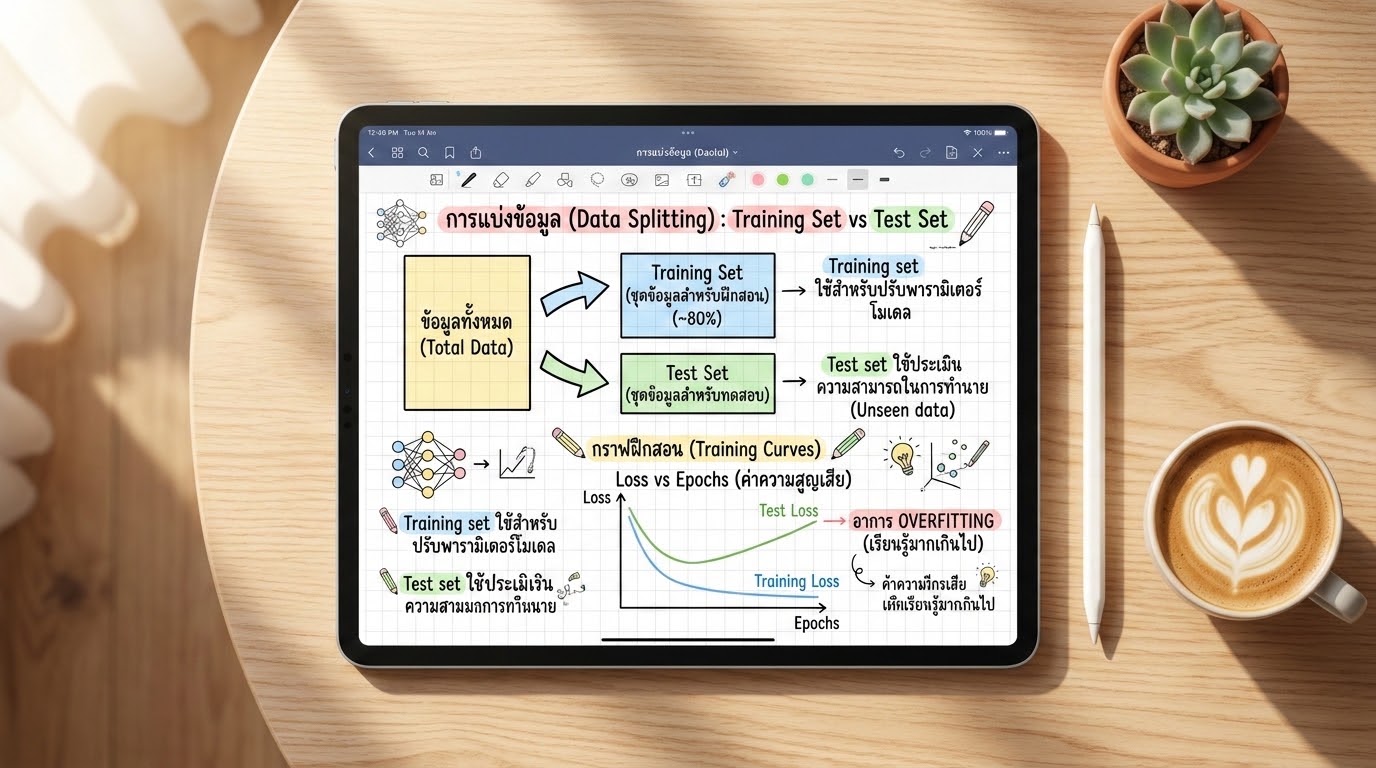
โศกนาฏกรรมครั้งนี้ไม่ได้เกิดจากโค้ดรันเอเรอร์ครับ แต่มันเกิดจากสิ่งที่พี่เรียกว่า “The Exam Leakage (ข้อสอบรั่วไหล)” คุณเผลอนำเอาชุดข้อมูลที่ใช้สอนเครื่อง (Training Set) ไปใช้เป็นข้อสอบวัดผล (Test Set) ด้วย! เครื่องเลยไม่ได้ใช้สติปัญญาคิดหาคำตอบ แต่มันใช้การ “ท่องจำสเปกข้อสอบเก่า” ไปตอบอย่างสมบูรณ์แบบ วันนี้พี่วิศวกร AI จะพาน้อง ๆ มาจิบกาแฟสกัดแก่นแท้ของกระบวนการ Training vs. Testing กลไกควบคุมเสถียรภาพตัวแปรที่วิศวกรปัญญาประดิษฐ์ระดับแนวหน้าไม่มีวันก้าวพลาดกันครับ!
🧠 ทฤษฎีและหลักการเบื้องหลัง (Theoretical Framework)
ในทางวิศวกรรมการเรียนรู้ของเครื่อง กระบวนการทั้งหมดตั้งอยู่บนฐานคิดสถิติศาสตร์ที่เรียกว่า Generalization (ความสามารถในการประยุกต์ใช้ปัญญาเพื่อตอบโจทย์ใหม่) เพื่อพิสูจน์สิ่งนี้ เราจำเป็นต้องเข้าใจกลไกภายในที่เกิดขึ้นเมื่อเครื่องเรียนรู้และสอบวัดผลครับ:
1. กระบวนการฝึกสอน (Training Phase): การปรับจูน Weights & Biases
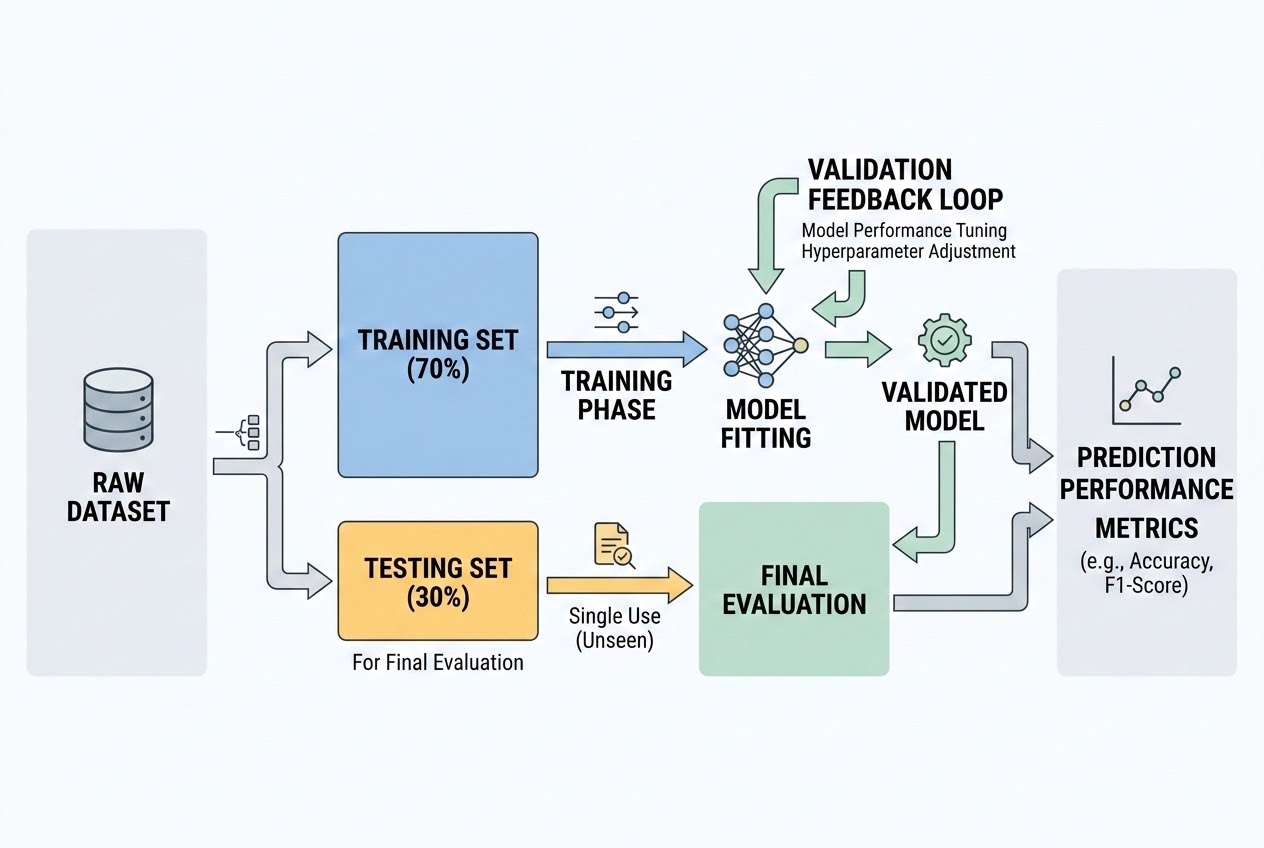
ขั้นตอน Training คือขั้นตอนที่โมเดลพยายามหาค่าพารามิเตอร์ภายในที่ดีที่สุด (เรียกว่า Weights $\mathbf{w}$ และ Bias $b$) เพื่อแมปคุณลักษณะนำเข้า (Features $\mathbf{x}$) ไปสู่ป้ายเฉลยผลลัพธ์ (Label $y$) ผ่านขั้นตอนคณิตศาสตร์วนลูปดังนี้:
Forward Pass (ส่งผ่านข้อมูลคำนวณทำนาย): โมเดลรับข้อมูล $\mathbf{x}$ เข้ามาประมวลผลผ่านสมการสมมติฐานเริ่มต้น เช่น:
$$ \hat{y} = \mathbf{w}^T \mathbf{x} + b $$
โดยค่าพารามิเตอร์ $\mathbf{w}$ และ $b$ ในรอบแรกสุดจะเป็นเพียงแค่ตัวเลขที่สุ่มขึ้นมาแบบเดาสุ่มเดาเดา ส่งผลให้คำทำนาย $\hat{y}$ มีความคลาดเคลื่อนสูงมาก
Loss Calculation (วัดระดับความล้มเหลว): นำคำทำนาย $\hat{y}$ ไปเทียบกับป้ายเฉลยจริง $y$ ผ่านฟังก์ชันสูญเสีย เช่น Mean Squared Error (MSE) สำหรับงานทำนายตัวเลข:
$$ \text{MSE} = \frac{1}{N} \sum_{i=1}^{N} (y_i - \hat{y}_i)^2 $$
Backward Pass / Optimization (ปรับค่าทางลาดเอียง): อัลกอริทึมเรียนรู้ (เช่น Gradient Descent) จะทำการหาอนุพันธ์เทียบหาทิศทางของค่าสูญเสียเพื่อปรับลดข้อผิดพลาดลง และทำการขยับค่าพารามิเตอร์ตามสมการปรับปรุง:
$$ \mathbf{w}{new} = \mathbf{w}{old} - \eta \nabla L(\mathbf{w}) $$
โดยที่ $\eta$ คืออัตราการเรียนรู้ (Learning Rate) เครื่องจะกระทำการวนลูปรอบ (Epochs) เช่นนี้ซ้ำ ๆ นับพันนับหมื่นรอบจนได้ค่าพารามิเตอร์ที่ Loss ต่ำที่สุด
2. กระบวนการวัดผลตรวจสอบ (Testing Phase): การสอบระดับ Generalization
คำถามคือ… “ถ้าโมเดลปรับจูนพารามิเตอร์จนกระทั่งตอบคำถามบนชุด Training Set ได้ถูกต้อง 100% แปลว่ามันเก่งแล้วใช่หรือไม่?” คำตอบคือ “ไม่ใช่” ครับ!
เพราะมันอาจเป็นเพียงสภาวะ Overfitting (การปรับสมการคดเคี้ยวไปท่องจำรอยพิกเซลขยะหรือนอยส์ในดาต้าฝึกสอน) เพื่อพิสูจน์สติปัญญาที่แท้จริง เราจึงต้องแบ่งแยกชุดข้อมูลออกเป็นสัดส่วนสากล:
- Training Set (ชุดฝึกสอน): เปรียบเสมือน “หนังสือเรียนและข้อสอบเก่าท้ายบท” ที่อนุญาตให้เครื่องสแกนและหาความลาดชันเพื่อปรับจูนตัวแปร Weights ของตนเองซ้ำ ๆ
- Testing Set (ชุดข้อสอบจริง): เปรียบเสมือน “ข้อสอบจริงในห้องสอบที่ไม่เคยรั่วไหลออกไปข้างนอก” ข้อมูลชุดนี้ห้ามนำมาปะปนในขั้นตอนการเรียนรู้เด็ดขาด มีหน้าที่ดึงมาป้อนให้โมเดลทำนายเพียงรอบเดียวตอนเรียนจบ เพื่อประเมินค่าคะแนนประสิทธิผลที่แท้จริงในการนำไปใช้แก้ปัญหาอุตสาหกรรมในโลกจริง (Unseen Data)
Senior AI Brother’s Analogy: ลองเปรียบเทียบการเรียนรู้ของเครื่องกับการติวหนังสือสอบของนักเรียน:
- หากคุณให้แนวข้อสอบพร้อมเฉลย 100 ข้อเดียวกัน กับเด็กไปนั่งท่องจำข้ามคืน พอรุ่งเช้าคุณเอาข้อสอบ 100 ข้อเดิมเป๊ะ มาจัดสอบ เด็กที่ขี้เกียจและท่องจำเก่ง (Overfitting) จะสอบได้คะแนนเต็ม 100 คะแนนเต็มอย่างแน่นอน
- แต่เมื่อไหร่ก็ตามที่คุณเปลี่ยนแนวข้อสอบเป็นโจทย์พลิกแพลงชุดใหม่ (Test Set) เด็กที่ใช้สิริปัญญาในการเชื่อมโยงโครงสร้างแก่นแท้คณิตศาสตร์เท่านั้นที่จะสอบผ่านได้อย่างมีคุณภาพ ส่วนเด็กที่ท่องจำจะทำไม่ได้เลยแม้แต่ข้อเดียว
The Danger of Over-tuning on Test Set (ระวังการจูนโมเดลเพื่อเอาใจข้อสอบ): จำไว้เป็นกฎหลักของวิศวกร MLOps ครับ! ห้ามปรับไฮเปอร์พารามิเตอร์ (เช่น ความลึกของต้นไม้ตัดสินใจ) ไปเรื่อย ๆ เพียงเพื่อหวังให้คะแนนสอบชุด Testing Set ออกมาสูงที่สุด เพราะเท่ากับว่าคุณกำลังแอบเปิดข้อสอบข้อนั้นให้โมเดลดูระหว่างทางล้อมอ้อม! ทางแก้ที่ดีที่สุดคือการซอยสัดส่วนข้อมูลส่วนที่สามที่เรียกว่า Validation Set (ชุดตรวจทานทางเลือก) มาใช้สำหรับจูนโมเดล และเก็บ Test Set ไว้เปิดทดสอบสแกนเพียงรอบสุดท้ายสุดก่อน Deploy สู่ไลน์อุตสาหกรรมเท่านั้นครับ
Stratification (การรักษาสัดส่วนคลาสสถิติ): เมื่อทำการแบ่งข้อมูลเพื่อวัดผล ตรวจทานให้ดีว่าคลาสป้ายเฉลยเฉลี่ยของคุณไม่กองอยู่ฝั่งเดียว เช่น ในกรณีสินค้าเสียมีแค่ 1% หากคุณทำการสุ่มสปิริดแบ่งโดยไม่คุมเปอร์เซ็นต์ (Stratify) ชุดทดสอบของคุณอาจจะมีแต่สินค้าดีร้อยเปอร์เซ็นต์ ทำให้คะแนนสอบออกมาลวงตาว่าทำได้ถูกต้องสมบูรณ์แบบเสมอนั่นเองครับ
🛠️ ขั้นตอนการทดลองและติดตั้ง (Implementation Guide)
ในห้องปฏิบัติการคอมพิวเตอร์ของคุณในบ่ายวันนี้ คุณจะได้พบกับไลบรารี Scikit-learn ซึ่งมีเครื่องมือสำคัญอย่าง train_test_split มาทำกระบวนการจัดสรรพาร์ติชันข้อสอบแบบอัตโนมัติ เรามาดูแนวทางการเขียนโค้ดและแกะพารามิเตอร์สากลไปพร้อมกันครับ:
import numpy as np
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier
from sklearn.metrics import accuracy_score
# =====================================================================
# 1. จัดเตรียมคลังข้อมูลและคุณลักษณะ (Features & Labels)
# =====================================================================
# จำลองสัดส่วนขนาดชิ้นงานแผงวงจรในสายพานการผลิต 20 แถวข้อมูล
np.random.seed(42)
X_vibration = np.random.uniform(1.0, 5.0, (20, 1)) # ระดับการสั่นของสปินเดิล
y_failure = np.where(X_vibration > 3.2, 1, 0).flatten() # ชำรุดถ้าสั่นเกิน 3.2 G
# =====================================================================
# 2. ทำการสับเปลี่ยนและสกัดแยกรอยต่อ Training vs Testing (Train/Test Split)
# =====================================================================
# แบ่งข้อมูลให้ Training Set 70% และ Testing Set 30% ทันที
X_train, X_test, y_train, y_test = train_test_split(
X_vibration, y_failure,
test_size=0.30, # กำหนดอัตราทดสอบที่ 30%
random_state=42, # ล็อคค่า seed เพื่อให้รันกี่ครั้งก็ได้ผลสับเปลี่ยนเดิม
stratify=y_failure # ล็อคการกระจายตัวของสัดส่วนคลาสดี/เสียให้เท่ากันทั้งสองชุด
)
# =====================================================================
# 3. เริ่มขั้นตอนกระบวนการเรียนรู้ (Training Process)
# =====================================================================
model_tree = DecisionTreeClassifier(max_depth=5)
# Machine ปรับแต่ง Weights/Biases โดยสแกนได้เฉพาะ X_train และ y_train เท่านั้น
model_tree.fit(X_train, y_train)
# =====================================================================
# 4. ขั้นตอนวัดประเมินความสามารถ Generalization (Testing Process)
# =====================================================================
# 4.1 วัดคะแนนบนชุดข้อมูลเก่าที่เครื่องใช้เรียน (Train Accuracy)
train_preds = model_tree.predict(X_train)
train_accuracy = accuracy_score(y_train, train_preds)
# 4.2 วัดคะแนนจริงบนข้อสอบใหม่ที่ไม่เคยเห็นมาก่อน (Test Accuracy)
test_preds = model_tree.predict(X_test)
test_accuracy = accuracy_score(y_test, test_preds)
print("--- ผลสรุปวิเคราะห์การจัดแบ่งพิกัด Training vs Testing ---")
print(f"จำนวนตัวอย่างฝั่งเรียนรู้ (Train Samples): {len(X_train)} ชิ้น")
print(f"จำนวนตัวอย่างฝั่งข้อสอบ (Test Samples): {len(X_test)} ชิ้น")
print(f"1. คะแนนความแม่นยำบนข้อสอบเก่า (Train Accuracy): {train_accuracy * 100:.2f}%")
print(f"2. คะแนนความแม่นยำบนข้อสอบจริง (Test Accuracy): {test_accuracy * 100:.2f}%")📝 บทสรุปและสเกลถัดไป (Conclusion & Next Steps)
กระบวนการแยกชุดข้อมูลออกเป็น Training, Validation และ Testing คือรั้วขอบเขตความปลอดภัยเชิงวิศวกรรมที่คอยรับประกันว่า สมองกลปัญญาประดิษฐ์ของคุณจะทำงานได้อย่างมั่นคง ทรงประสิทธิภาพ และพร้อมลุยเคสใหม่ในโรงงานได้จริงโดยปราศจากการสบตาทำนายด้วยการท่องจำข้อสอบเก่าครับ!
เมื่อเราสามารถจำแนกกระบวนการฝึกสอนและการสอบประเมินสติปัญญาของเครื่องได้อย่างเฉียบคมแล้ว คำถามสากลข้อต่อไปที่คุณต้องก้าวข้ามคือ… “ในจักรวาลของโจทย์ธุรกิจนับล้านแบบ เครื่องมีพฤติกรรมและความต้องการในการฝึกฝนตามโจทย์ระบบและเป้าหมายที่แตกต่างกันอย่างไร?”
เตรียมตัวลุยต่อและติดตามอ่านสาระปฏิวัติเทคโนโลยีล่วงหน้าได้ในตอนถัดไป: “ตอนที่ 11: ประเภทของ Machine Learning — ถอดรหัส 3 มรรคาวิธีแห่งปัญญาประดิษฐ์จาก Supervised สู่ระบบเรียนรู้ไร้เฉลยและรางวัลสะท้อนกลับ” คอยสแกนข้อมูลและจดชอร์ตโน้ตลง Obsidian ของคุณล่วงหน้ากันได้เลยครับวิศวกรรุ่นน้อง!