ตอนที่ 7: 3 เสาหลักของ Machine Learning — ถอดรหัสโครงสร้างวิศวกรรมปัญญาประดิษฐ์ขั้นพื้นฐาน
ลองจินตนาการว่าคุณเป็นวิศวกรควบคุมระบบอัตโนมัติในสายพานการผลิตขวดน้ำอัจฉริยะ วันดีคืนดีเกิดปัญหาขวดพลาสติกมีความหนาไม่ได้มาตรฐานหลุดรอดการสแกนของพนักงาน จนลูกค้าส่งสินค้าตีกลับมาที่โรงงาน คุณได้รับโจทย์เร่งด่วนมาว่า “ช่วยสร้างระบบปัญญาประดิษฐ์มาคัดแยกขวดน้ำที่ชำรุดเหล่านี้ออกจากสายพานแบบ Real-time ที!”
หากมองจากมุมนอก วงการไอทีอาจจะบอกคุณว่า “ก็แค่ไปเอารูปขวดดีขวดเสียมา แล้วโยนมันเข้าไปในโครงข่ายประสาทเทียมลึกๆ สิ เดียวมันก็คิดคำตอบให้เอง!” แต่สำหรับเหล่านักพัฒนาและวิศวกร AI ที่ต้องสวมหมวกสถาปนิกคุมระบบจริง การ “เดา” และทำตามคำบอกเล่าแบบไม่มีทิศทางคือหนทางสั้นๆ สู่ความล้มเหลวเชิงโครงสร้างครับ
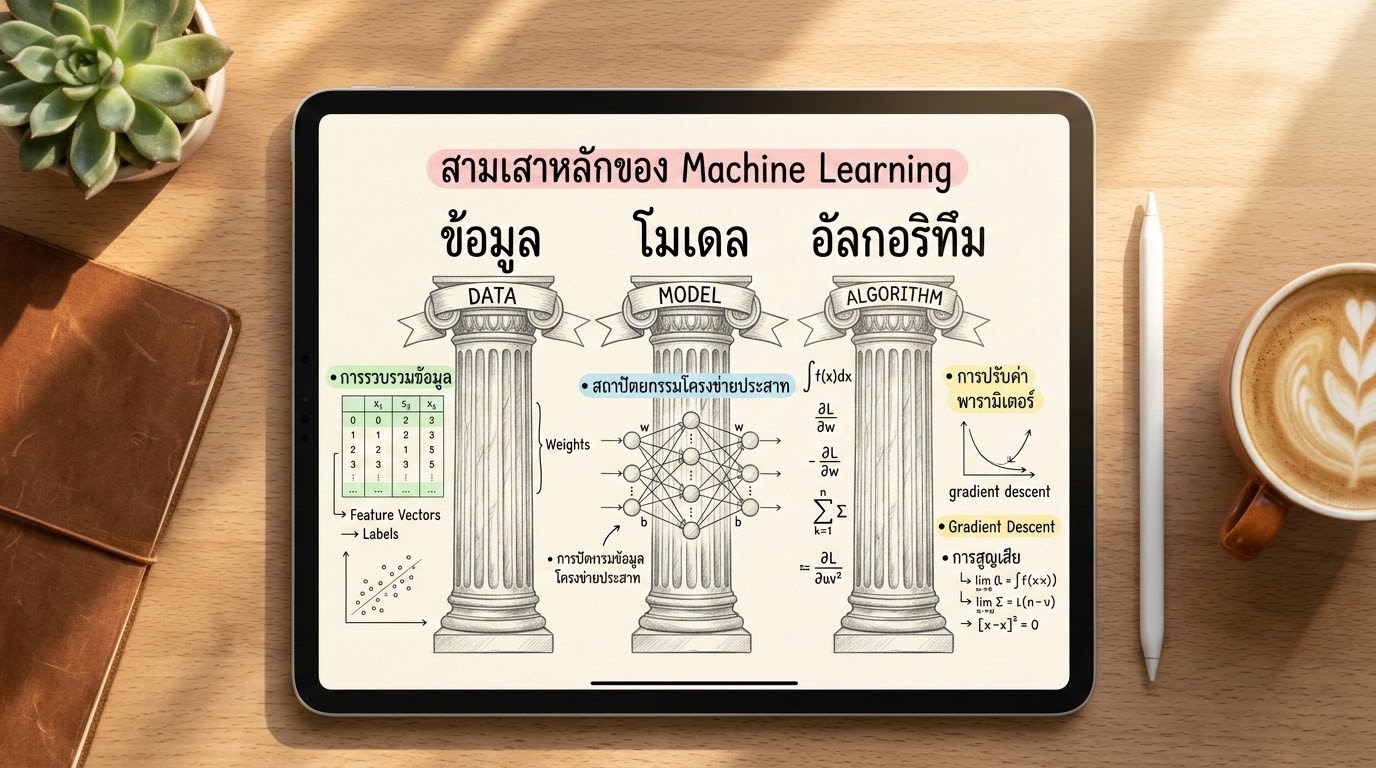
เพราะแท้จริงแล้ว ระบบการเรียนรู้ของเครื่องหรือ Machine Learning (ML) ไม่ใช่เรื่องของเวทมนตร์ลึกลับ แต่เป็นระบบวิศวกรรมที่ตั้งอยู่บนรากฐานที่มั่นคงของ “3 เสาหลัก (Three Pillars)” ทางคณิตศาสตร์และสถิติศาสตร์ หากขาดเสาหลักต้นใดต้นหนึ่งไป สมองกลของคุณจะไม่มีวันทำงานได้เลย วันนี้พี่วิศวกร AI จะพามาจิบกาแฟและกางแผนผังโครงสร้างของ 3 เสาหลักนี้ เพื่อเตรียมความพร้อมไปลุยข้อสอบและเวิร์กช็อปร่วมกันครับ!
🧠 ทฤษฎีและหลักการเบื้องหลัง (Theoretical Framework)
ในกรอบการทำงานวิจัยด้านวิทยาศาสตร์คอมพิวเตอร์และการเรียนรู้เชิงคณิตศาสตร์ ระบบแมชชีนเลิร์นนิงทุกชนิดในโลกจะถูกประกอบสร้างขึ้นจาก 3 องค์ประกอบหลักที่พึ่งพาอาศัยกันอย่างสมบูรณ์แบบ ได้แก่ ข้อมูล (Data), โมเดลคณิตศาสตร์ (Mathematical Model) และ อัลกอริทึมการเรียนรู้ (Learning Algorithm)
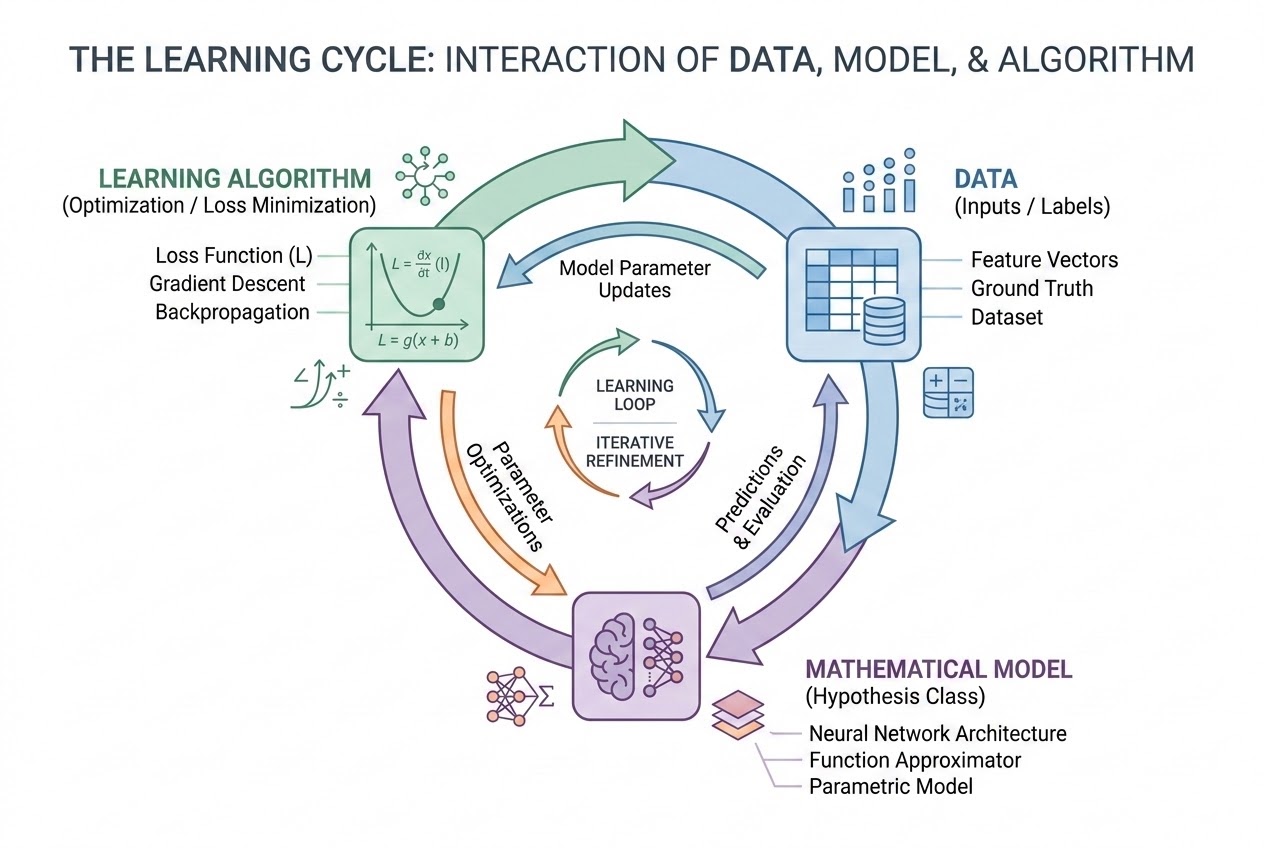
🧱 เสาหลักที่ 1: ข้อมูล (Data) — วัตถุดิบและตัวแทนประสบการณ์จริง
คุณไม่สามารถสร้างปัญญาประดิษฐ์ขึ้นมาได้หากไม่มีข้อมูลเปรียบเทียบ ในทางสถิติ ข้อมูลคือตัวแทน “ประสบการณ์ (Experience)” ของสิ่งแวดล้อมที่เครื่องใช้ศึกษา โดยข้อมูลที่ดีต้องมีตัวแทนลักษณะทางกายภาพที่ครบถ้วน (Representative Data)
ภายใต้เสาหลักของข้อมูล เราสามารถจำแนกโครงสร้างออกเป็นส่วนย่อยๆ ตามมาตรฐานวิชาการได้ดังนี้ครับ:
- Domain Set หรือ Instance Space ($ \mathcal{X} $): คือกลุ่มของออบเจกต์หรือสิ่งที่เราสนใจทั้งหมดในระบบ เช่น รูปภาพขวดน้ำ หรือสัญญาณเครื่องจักร โดยทั่วไปจะถูกนำมาแปลงให้อยู่ในรูปตัวเลขหลายมิติที่เรียกว่า “เวกเตอร์คุณลักษณะ (Feature Vector)” ($ x \in \mathcal{X} $) เช่น ความกว้าง ความหนา และดัชนีการสะท้อนแสง [142, 144]
- Label Set ($ \mathcal{Y} $): คือกลุ่มของ “เฉลยคำตอบปลายทางที่ถูกต้อง” ที่เราคาดหวังให้โมเดลทำนาย เช่น ในระบบตรวจสอบขวดน้ำ $ \mathcal{Y} = {0, 1} $ โดย $ 1 $ หมายถึง ขวดน้ำสมบูรณ์ และ $ 0 $ หมายถึง ขวดชำรุด
- Training Sample ($ S $): คือชุดข้อมูลจริงที่เครื่องมีสิทธิ์เข้าถึงเพื่อใช้ในขั้นตอนการเรียนรู้ เขียนในรูปของคู่พิกเซลและเฉลย [143, 144]:
$$ S = ((x_1, y_1), (x_2, y_2), \dots, (x_m, y_m)) \in (\mathcal{X} \times \mathcal{Y})^m $$
โดยข้อมูลแต่ละคู่ลำดับจะถูกสุ่มหยิบยกออกมาอย่างเป็นอิสระต่อกันจากความน่าจะเป็นในโลกจริงที่มีการกระจายตัวแบบเท่ากัน (Independent and Identically Distributed: i.i.d.)
🧱 เสาหลักที่ 2: โมเดลคณิตศาสตร์ (Mathematical Model / Hypothesis Class) — ขอบเขตจินตนาการของสมองกล
หลังจากมีวัตถุดิบแล้ว เสาหลักต้นที่สองคือการเลือก “โมเดล” หรือที่ตำราคณิตศาสตร์ ML เรียกว่า “Hypothesis Class ($ \mathcal{H} $)”
- ความหมายเชิงโครงสร้าง: Hypothesis Class คือเซตของ “ฟังก์ชันคณิตศาสตร์ทั้งหมด” ที่เราอนุญาตให้ระบบทดลองนำมาสางและจับความสัมพันธ์เพื่อทำนายเฉลยจากข้อมูลดิบ ($ h : \mathcal{X} \to \mathcal{Y} $)
- การเลือกขนาดของโมเดล: หากเราเลือกโมเดลที่มีโครงสร้างง่ายเกินไป เช่น ฟังก์ชันเส้นตรงธรรมดา ($ y = w x + b $) แต่ลักษณะทางฟิสิกส์จริงของปัญหาในโรงงานมีความบิดเบี้ยวไม่เป็นเส้นตรง (Non-linear) โมเดลของเราจะไม่มีวันทำนายได้แม่นยำเลย ซึ่งสภาวะนี้เรียกว่ามี Approximation Error สูง (หรือเรียกว่าเกิด Underfitting)
- ทางแก้เชิงวิศวกรรม: เราสามารถลดความคลาดเคลื่อนนี้ได้ด้วยการยกระดับเลือกใช้โมเดลที่มีความซับซ้อนสูงขึ้น (Expressive Class) เช่น โครงข่ายประสาทเทียมระดับลึก (Deep Neural Network) เพื่อขยายขนาดของ Hypothesis Class ให้กว้างพอที่จะครอบคลุมสูตรที่ซับซ้อนได้
🧱 เสาหลักที่ 3: อัลกอริทึมการเรียนรู้ (Learning Algorithm & Loss Minimization) — ฟันเฟืองค้นหาคำตอบที่ดีที่สุด
เมื่อเราจำกัดสเปซของโมเดล ($ \mathcal{H} $) เรียบร้อยแล้ว คำถามถัดไปคือ “เราจะเลือกฟังก์ชัน $ h $ ตัวไหนจากล้านๆ รูปแบบในเซตมารับหน้าที่ทำนายขวดน้ำจริง?” นี่คือจุดที่เสาหลักต้นที่สามเข้ามาทำหน้าที่เป็น “คุณครูสอนเครื่อง” ครับ
กระบวนการนี้ทำงานผ่านฟันเฟืองทองคำย่อยๆ 2 ชิ้น:
- Loss Function ($ \ell $): ตัววัดความล้มเหลว ทำหน้าที่เปรียบเทียบว่าคำทำนายของฟังก์ชันกับเฉลยจริงห่างกันแค่ไหน เช่น การใช้ความคลาดเคลื่อนกำลังสอง (Squared Loss) สำหรับงานทำนายตัวเลข
$$ \ell(h(x), y) = (h(x) - y)^2 $$
- Optimization Algorithm: ตัวนำทางคณิตศาสตร์ (เช่น Gradient Descent หรือ Adam) ที่ทำหน้าที่ไล่ล่าปรับค่าพารามิเตอร์ภายในโมเดลเพื่อลดค่า ความเสี่ยงเชิงประจักษ์ (Empirical Risk) หรือค่าเฉลี่ยข้อผิดพลาดบนชุดข้อมูลฝึกสอน ($ L_S(h) $) ให้เหลือต่ำที่สุด ซึ่งเรียกว่ากฎ Empirical Risk Minimization (ERM)
Senior AI Brother’s Analogy: หากคุณต้องการเทรนพนักงานตรวจจับคุณภาพชิ้นงาน:
- Data คือ คลังชิ้นงานตัวอย่างที่มีตำหนิจริงพร้อมเฉลยในห้องเก็บของที่คุณขนมาให้พนักงานลองฝึกสังเกต
- Model (Hypothesis Class) คือ ขีดจำกัดทางสติปัญญา รูปแบบการประมวลผล หรือกรอบทฤษฎีที่พนักงานสามารถคิดขึ้นได้ในหัว
- Learning Algorithm คือ กลไกการประเมินคะแนนของอาจารย์ที่คอยเฉลยและลงโทษเมื่อพนักงานมองพลาด (Loss) และสั่งให้พนักงานปรับเปลี่ยนพฤติกรรมการตัดสินใจทีละนิดจนสอบผ่าน
🛠️ ขั้นตอนการทดลองและติดตั้ง (Implementation Guide)
เพื่อสอดรับกับการทำเวิร์กช็อปของคุณในชั้นเรียน เรามาลองเขียนโค้ดภาษา Python ด้วยไลบรารี Scikit-learn และ NumPy เพื่อแกะรอยการทำงานร่วมกันของ 3 เสาหลักนี้ในโปรแกรมประมวลผลเชิงตัวเลขจริงกันครับ:
import numpy as np
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_squared_error
# =====================================================================
# เสาหลักที่ 1: DATA (จัดเตรียมชุดข้อมูลดิบและเฉลย)
# =====================================================================
# คุณลักษณะ (Features): [ปริมาณชิ้นงานที่ผลิตต่อชั่วโมง, อุณหภูมิหน้าเตาหลอม (C)]
X_features = np.array([
[100, 45.2], [120, 48.5], [85, 40.1], [150, 52.0], [90, 42.5],
[110, 46.0], [130, 49.2], [75, 38.0], [105, 44.8], [95, 43.0]
])
# เฉลยค่าการใช้พลังงานไฟฟ้าจริงของเครื่องจักรในชั่วโมงนั้น (kWh) (Labels)
y_labels = np.array([250, 290, 210, 360, 220, 270, 310, 180, 260, 230])
# =====================================================================
# เสาหลักที่ 2: MATHEMATICAL MODEL (กำหนดสเปซของสมมติฐาน)
# =====================================================================
# เรากำหนดขอบเขตสมองเป็น Linear Hypothesis Class: y = w1*x1 + w2*x2 + b
hypothesis_space = LinearRegression()
# =====================================================================
# เสาหลักที่ 3: LEARNING ALGORITHM (รันกลไกค้นหาพารามิเตอร์ที่ Loss ต่ำสุด)
# =====================================================================
# อัลกอริทึมจะใช้ Ordinary Least Squares เพื่อสางสมการและอัปเดต weights
# โดยยึดเอาค่า Mean Squared Error บนตารางรถไฟนี้เป็น Loss หลักที่ต้องลดลง
hypothesis_space.fit(X_features, y_labels) # คืนค่า h(x) ที่ดีที่สุดในรุ่นกลับมา
# =====================================================================
# 🔍 การแสดงผลวิเคราะห์ทางสถิติเบื้องหลัง
# =====================================================================
# ทำนายผลชิ้นงานตัวอย่างใหม่
new_hour_test = np.array([[115, 47.0]])
predicted_kwh = hypothesis_space.predict(new_hour_test)
print("--- ผลลัพธ์สรุปกระบวนการเทรนของ 3 เสาหลัก ---")
print(f"ค่าน้ำหนัก Weights (w1, w2) ที่เรียนรู้ได้เอง: {hypothesis_space.coef_}")
print(f"ค่า Bias (b) จุดตัดแกนสถิติ: {hypothesis_space.intercept_:.4f}")
print(f"ผลการทำนายปริมาณการใช้ไฟฟ้าในระบบผลิตชิ้นงานใหม่: {predicted_kwh[0]:.2f} kWh")⚠️ ข้อควรระวังและแนวทางปฏิบัติที่ดีที่สุด (Pitfalls & Best Practices)
The Overfitting Pitfall (ภัยมืดของการจำข้อสอบ): หากคุณพยายามใช้เสาหลักต้นที่ 2 (Model) ที่มีความหนาแน่นและซับซ้อนสูงมากเกินไปมาเทรนบนเสาหลักต้นที่ 1 (Data) ที่มีปริมาณตัวอย่างที่น้อยเกินไป ระบบคำนวณจะทำการปรับ weights ให้เข้าหาข้อมูลฝึกสอนแบบ 100% จนได้ค่าความชันคดเคี้ยวไปมาเพื่อเอาใจข้อสอบจำเพาะ ส่งผลให้เมื่อนำโมเดลไป Deploy ตรวจสอบขวดน้ำหน้างานจริง ค่าคะแนนการสแกนจะแย่ลงอย่างมหาศาล (เกิดสภาวะ Overfitting)
The Mismatch objective (ความต่างขั้วระหว่างค่า Loss และความต้องการธุรกิจ): พึงระลึกไว้เสมอว่า ตัววัดความคลาดเคลื่อนทางคณิตศาสตร์ที่เรากำหนดให้ อัลกอริทึมค้นหา (เช่น Cross-entropy หรือ Squared Loss) บางครั้งอาจจะไม่สอดรับเป็นเนื้อเดียวกับดัชนีประสิทธิภาพทางธุรกิจ (เช่น เปอร์เซ็นต์การตรวจชิ้นงานชำรุดผิดพลาด) วิศวกร AI จึงต้องคุมเสถียรภาพและตรวจสอบความสัมพันธ์นี้ให้สอดรับกันด้วยครับ
📝 บทสรุปและสเกลถัดไป (Conclusion & Next Steps)
การเข้าใจถึงปฏิสัมพันธ์อันลึกซึ้งของ ข้อมูล, โมเดลคณิตศาสตร์ และอัลกอริทึมการเรียนรู้ จะช่วยให้คุณปรับขอบเขตและมุมมองโครงสร้างระบบในห้องเวิร์กช็อปได้อย่างมั่นใจ คุณจะรู้ทันทีว่าเมื่อโมเดลทำคะแนนออกมาได้ไม่ดี ปัญหานั้นมาจากวัตถุดิบ (Data), ขีดความสามารถสมอง (Model Capacity) หรือเป็นเพราะคุณตั้งค่าวิธีการคำนวณปรับพารามิเตอร์ผิดพลาดกันแน่
แต่ในบรรดาเสาหลักทั้งสามสีนี้ มีวิศวกรอาวุโสหลายท่านกล่าวไว้ว่า "ข้อมูล (Data) เป็นเสาหลักที่ต้องการความประณีตและการดูแลจากมนุษย์สูงที่สุด" เพราะหากวัตถุดิบเสียหาย โมเดลและสถิติขั้นเทพแค่ไหนก็ไม่อาจกู้ชีวิตระบบได้ครับ
ในตอนหน้า เราจะมาเจาะลึกที่เสาต้นแรกแบบเน้นๆ: "ตอนที่ 8: ทำความรู้จัก Data ในโลกของ ML — เปิดรหัสการจัดโครงสร้าง คอลัมน์ และเวกเตอร์คุณสมบัติสำหรับระบบสมองกล" ห้ามพลาดบทความตอนถัดไปด้วยความยินดีเป็นอย่างยิ่งครับ!