ตอนที่ 12: Supervised Learning (การเรียนรู้แบบมีผู้สอน) — ถอดรหัสแผนผังสมการถดถอยและกลไกคัดแยกประเภท
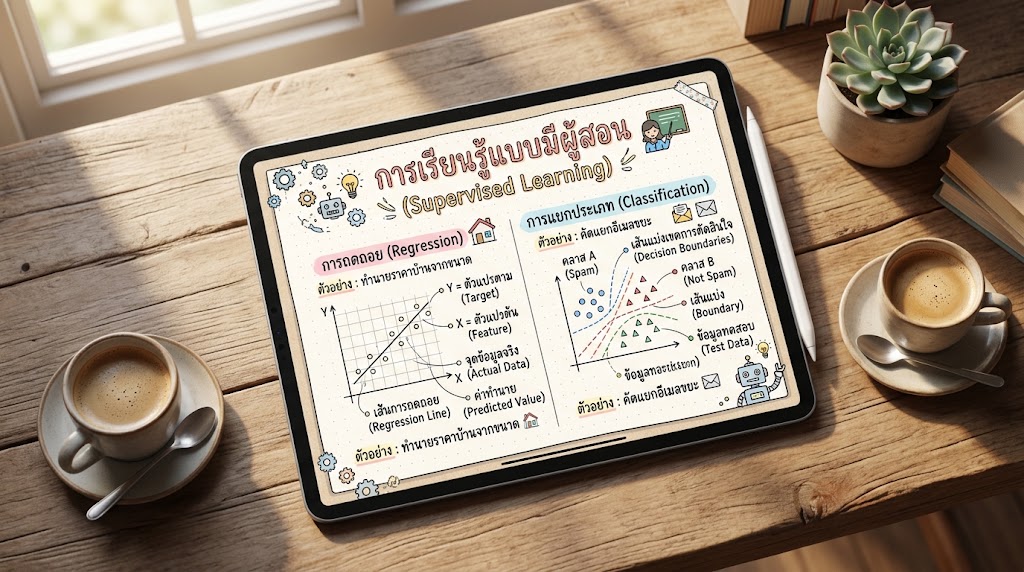
ลองจินตนาการถึงเช้าวันจันทร์อันแสนวุ่นวายในโรงงานบรรจุเครื่องดื่มกระป๋องอัจฉริยะ หัวหน้าแผนกควบคุมคุณภาพวิเคราะห์ผล (QC) เดินหน้าเครียดมาหาคุณพร้อมกับข้อมูลกองโต: “แกนเพลาของเครื่องจักรตัวนี้เริ่มสั่นสะเทือนหนักขึ้นเรื่อยๆ เราอยากได้ AI ที่ช่วยตอบเราทีว่าเครื่องจักรจะพังในอีกกี่ชั่วโมงข้างหน้า (Regression) และตอนนี้สภาพของหัวเจาะจัดอยู่ในเกณฑ์ ปกติ หรือ ผิดปกติ (Classification) ก่อนที่เครื่องจะระเบิดจนสายการผลิตหยุดทำงาน!”
ในฐานะวิศวกรปัญญาประดิษฐ์ หากคุณต้องการสร้างระบบคัดแยกและทำนายผลที่มีเสถียรภาพสูงในระดับนี้ อาวุธชิ้นแรกที่คุณต้องเลือกใช้อย่างแม่นยำคือ Supervised Learning (การเรียนรู้แบบมีผู้สอน)
เพราะในความเป็นจริงของหน้างานอุตสาหกรรม โมเดล AI จะไม่มีวันเดาใจมนุษย์หรือมองภาพออกเองได้หากปราศจากการป้อน “ชุดข้อมูลที่มีเลเบลเฉลยกำกับ (Labeled Data)” เข้าไปเป็นคู่มือให้มันลองผิดลองถูกในห้องเรียนจำลอง วันนี้พี่ Senior AI Engineer จะพามาจิบกาแฟขุดลึกคณิตศาสตร์เบื้องหลังและดูขั้นตอนสาทรโค้ดจริงไปพร้อมๆ กันครับ!
🧠 ทฤษฎีและหลักการเบื้องหลัง (Theoretical Framework)
แก่นแท้ของ Supervised Learning คือการสร้างโมเดลคณิตศาสตร์เพื่อหาความสัมพันธ์หรือ “แผนผัง (Mapping Function)” จากเซตของคุณลักษณะนำเข้า (Features: $\mathbf{x}$) ไปสู่เป้าหมายปลายทางที่ถูกต้อง (Label: $y$) โดยเราจะฝึกโมเดลด้วยชุดข้อมูลประวัติศาสตร์ฝึกสอน (Training Set):
$$ S = {(\mathbf{x}_1, y_1), (\mathbf{x}_2, y_2), \dots, (\mathbf{x}_m, y_m)} $$
โดยที่ $\mathbf{x}_i \in \mathcal{X}$ คือเวกเตอร์มิติของคุณสมบัติชิ้นงาน และ $y_i \in \mathcal{Y}$ คือป้ายเฉลยที่มนุษย์หรือเครื่องมือวัดในอดีตได้ทำสัญกรณ์กำกับไว้
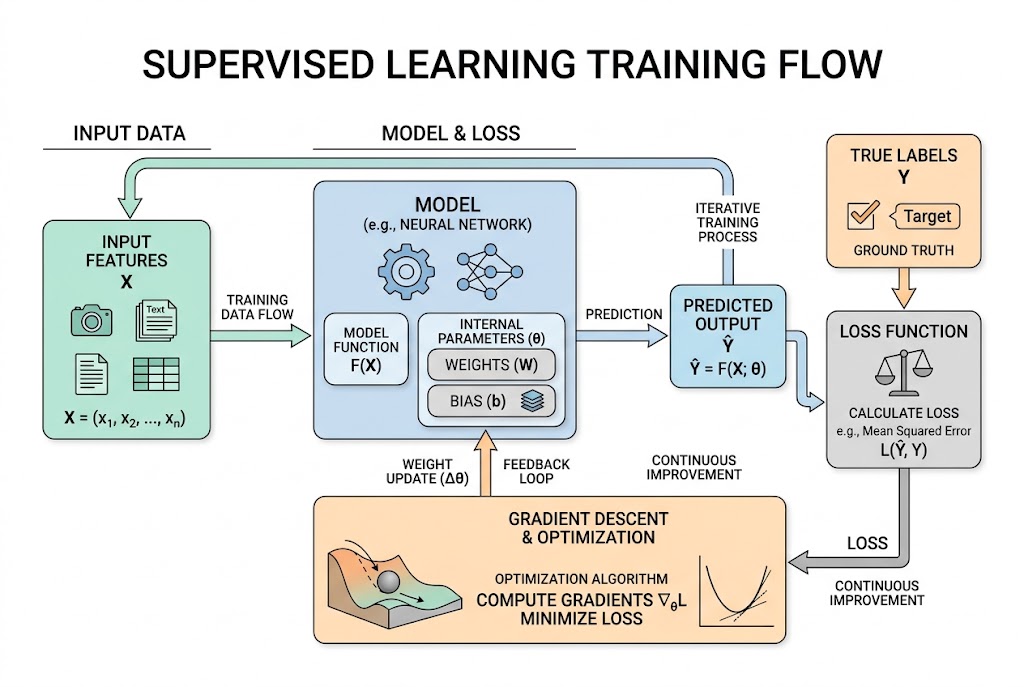
เมื่อเราจำแนกตามประเภทของป้ายเฉลยปลายทาง ($\mathcal{Y}$) เราจะสามารถแบ่ง Supervised Learning ออกเป็น 2 นิกายยักษ์ใหญ่ได้ดังนี้ครับ:
📊 1. Regression (การทำนายค่าต่อเนื่อง)
- เป้าหมาย: ทำนายหรือประมาณค่าของตัวแปรเป้าหมายที่เป็นตัวเลขต่อเนื่อง (Continuous Numerical Value)
- ขอบเขตคณิตศาสตร์: ป้ายเฉลยปลายทางจะอยู่ในสเปซจำนวนจริง ($y \in \mathbb{R}$)
- สูตรสมการเชิงเส้นพื้นฐาน: $$ y = \mathbf{w}^T \mathbf{x} + b $$ โดยที่ $\mathbf{w}$ คือเวกเตอร์ค่าน้ำหนัก (Weights) และ $b$ คือค่าส่วนเบี่ยงเบน (Bias) ที่เครื่องจักรต้องพยายามปรับจูนเพื่อลดค่า Loss เช่น Mean Squared Error (MSE) ให้เหลือน้อยที่สุด
- กรณีศึกษาในโรงงาน: การทำนายปริมาณการปล่อยก๊าซคาร์บอนไดออกไซด์ (CO2 Emissions) ของเครื่องยนต์, การประมาณอายุการใช้งานที่เหลืออยู่ของชิ้นส่วน (Remaining Useful Life - RUL) หรือการคาดการณ์ปริมาณการใช้พลังงานไฟฟ้าของเตาหลอมตามอุณหภูมิรอบเครื่อง
🎯 2. Classification (การจำแนกประเภทหมวดหมู่)
- เป้าหมาย: จัดกลุ่มหรือจำแนกประเภทข้อมูลนำเข้าให้อยู่ในกลุ่มหมวดหมู่ที่ไม่ต่อเนื่อง (Discrete Class/Category Labels)
- ขอบเขตคณิตศาสตร์: ป้ายเฉลยปลายทางจะอยู่ในสเปซจำนวนเต็มที่เป็นกลุ่มจำกัด เช่น $y \in {0, 1}$ (สองกลุ่ม หรือ Binary Classification) หรือ $y \in {1, 2, \dots, K}$ (หลายกลุ่ม หรือ Multi-class Classification)
- กรณีศึกษาในโรงงาน: การจำแนกเกรดของชิ้นงานแผงวงจร (Pass = 1, Fail = 0) จากภาพถ่ายวิชันกล้อง, การวิเคราะห์เสียงมอเตอร์เพื่อประเมินประเภทข้อบกพร่อง (ปกติ, ตลับลูกปืนฝืด, แกนเพลาเบี้ยว)
🛠️ ขั้นตอนการทดลองและติดตั้ง (Implementation Guide)
เพื่อให้น้องๆ มองเห็นภาพวิศวกรรมการแปลงทฤษฎีสู่ระบบโค้ดที่รันใช้งานได้จริง เรามาลองเขียนสคริปต์ภาษา Python ด้วยสถาปัตยกรรม Scikit-Learn ในไฟล์เดียว เพื่อรันงานทั้งเชิงถดถอย (Regression) คาดคะเนการใช้พลังงาน และงานคัดแยกประเภท (Classification) ชิ้นงานชำรุดกันครับ:
import numpy as np
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression
from sklearn.tree import DecisionTreeClassifier
from sklearn.metrics import mean_squared_error, accuracy_score
# =====================================================================
# 1. ⚙️ ฝั่ง REGRESSION: ทำนายค่าต่อเนื่อง (เช่น ค่ากำลังไฟฟ้าที่เครื่องจักรใช้)
# =====================================================================
print("--- [ส่วนที่ 1: งานถดถอยเชิงตัวเลข - Regression] ---")
# จำลองข้อมูล: [อุณหภูมิห้องเครื่อง (C), ความเร็วรอบหมุน (RPM)]
reg_X = np.array([
[45.5, 1200], [48.2, 1300], [40.1, 950], [52.0, 1500], [42.5, 1100],
[46.0, 1250], [49.2, 1400], [38.0, 900], [44.8, 1180], [43.0, 1050]
])
# เฉลยค่ากระแสไฟฟ้าที่วัดได้จริงในหน่วยกิโลวัตต์ (kW)
reg_y = np.array([2.5, 2.8, 1.8, 3.5, 2.1, 2.6, 3.1, 1.5, 2.3, 2.0])
# แบ่งข้อมูลออกเป็นชุดเรียนและชุดข้อสอบ
X_train_r, X_test_r, y_train_r, y_test_r = train_test_split(
reg_X, reg_y, test_size=0.3, random_state=42
)
# ประกาศเลือกโครงสร้างโมเดล Linear Regression
reg_model = LinearRegression()
# ให้แบบจำลองเรียนรู้และจูนค่าพารามิเตอร์ค่าน้ำหนัก
reg_model.fit(X_train_r, y_train_r)
# ให้โมเดลทำข้อสอบและวัดค่าความคลาดเคลื่อนทางสถิติ (MSE)
reg_predictions = reg_model.predict(X_test_r)
mse_loss = mean_squared_error(y_test_r, reg_predictions)
print(f"ค่าน้ำหนัก Weights ที่ปรับเรียนรู้ได้: {reg_model.coef_}")
print(f"ค่า Bias ในสมองกล: {reg_model.intercept_:.4f}")
print(f"ดัชนีความผิดพลาดของงาน Regression (MSE Loss): {mse_loss:.4f}\n")
# =====================================================================
# 2. 🎯 ฝั่ง CLASSIFICATION: จัดหมวดหมู่ชิ้นงานชำรุด (Pass = 1, Fail = 0)
# =====================================================================
print("--- [ส่วนที่ 2: งานจัดหมวดหมู่คัดแยกประเภท - Classification] ---")
# จำลองข้อมูลฟีเจอร์ชิ้นงาน: [ความกว้างช่องเปิด (มม.), ระดับการสั่นสะเทือน (G)]
clf_X = np.array([
[10.2, 0.15], [10.4, 0.18], [9.1, 0.85], [10.1, 0.12], [8.9, 0.92],
[10.3, 0.16], [10.5, 0.19], [9.3, 0.75], [10.0, 0.14], [9.0, 0.81]
])
# เฉลยคำตอบ: 1 = เกรดคุณภาพสแกนผ่าน (Pass), 0 = เกรดตกชำรุดคัดทิ้ง (Fail)
clf_y = np.array([1, 1, 0, 1, 0, 1, 1, 0, 1, 0])
X_train_c, X_test_c, y_train_c, y_test_c = train_test_split(
clf_X, clf_y, test_size=0.3, random_state=42
)
# เลือกใช้โมเดลต้นไม้ตัดสินใจ (Decision Tree Classifier)
clf_model = DecisionTreeClassifier(max_depth=2, random_state=42)
# เครื่องจักรปรับโครงสร้างต้นไม้หาเส้นแบ่งทางสถิติ
clf_model.fit(X_train_c, y_train_c)
# วัดคะแนนความแม่นยำในการทำนายรูปภาพชิ้นงานใหม่
clf_predictions = clf_model.predict(X_test_c)
accuracy = accuracy_score(y_test_c, clf_predictions)
print(f"คำทำนายเกรดชิ้นงานบนชุดข้อสอบ: {clf_predictions}")
print(f"เฉลยจริงบนชุดข้อสอบ: {y_test_c}")
print(f"คะแนนความแม่นยำของงาน Classification (Accuracy): {accuracy * 100:.2f}%")⚠️ ข้อควรระวังและแนวทางปฏิบัติที่ดีที่สุด (Pitfalls & Best Practices)
The Bias-Variance Tradeoff (สภาวะขัดแย้งของอคติและความแปรปรวน): พึงระลึกไว้เสมอว่า การเลือกความซับซ้อนของโมเดลคือหัวใจหลักครับ หากคุณเลือกโมเดลที่ง่ายเกินไป (High Bias) โมเดลของคุณจะ Underfit ทายผิดเฉื่อยชาทั้งตารางรถไฟและห้องสอบจริง แต่หากเลือกโมเดลที่พารามิเตอร์ล้นเหลือเกินความจำเป็น (High Variance) โมเดลจะจดจำค่าสถิติขยะหรือสัญญาณนอยส์ในฐานข้อมูลฝึกสอนมากเกินไปจน Overfit ซึ่งจะทายข้อสอบหน้างานพังพินาศในที่สุดครับ
The Crucial Need for Label Quality (วิกฤตความสะอาดของป้ายเฉลย): คอมพิวเตอร์ของคุณจะเรียนรู้ตามสิ่งที่คุณป้อนให้มันเท่านั้น หากพนักงาน QC ติดป้ายเฉลยผิดๆ ถูกๆ (Noisy Labels) เช่น เผลอระบุขวดน้ำชำรุดว่าปกติบ่อยครั้ง ตัวอัลกอริทึมก็จะจดจำสูตรที่เพี้ยนนั้นขึ้นมาสอนตนเอง ดังนั้นก่อนเริ่มรันกระบวนการเรียนรู้ วิศวกร AI จำเป็นต้องใช้กระบวนการคัดกรองข้อมูลว่างเปล่า (NaN) และตรวจสอบความสอดคล้องของป้ายเฉลยเป็นลำดับแรกเสมอครับ
📝 บทสรุปและสเกลถัดไป (Conclusion & Next Steps)
Supervised Learning เป็นสถาปัตยกรรมที่ทรงประสิทธิภาพและเป็นมิตรกับโจทย์ทางธุรกิจมากที่สุดในปัจจุบัน เนื่องจากโมเดลมีจุดหมายและเป้าวัดประสิทธิภาพที่เด่นชัดผ่านทางป้ายเฉลยนำทาง ไม่ว่าจะเป็นการพล็อตสมการเส้นตรงคาดการณ์พลังงานไฟฟ้า หรือการสร้างโครงสร้างจำแนกชิ้นงานเบี้ยวชำรุดบนสายพาน
อย่างไรก็ดี ในโลกแห่งข้อมูลอุตสาหกรรมขนาดใหญ่ บางครั้งการกว้านซื้อภาพถ่ายสินค้าแสนล้านชิ้นนับเป็นเรื่องง่าย แต่วิกฤตที่แท้จริงคือการที่โรงงานไม่มีงบประมาณหรือแรงงานพนักงาน QC มากพอที่จะมานั่งไล่เฉลยป้ายกำกับคัดเลือกภาพ (Labels) ให้ครบทุกใบ
แล้วเราจะแก้ปัญหานี้อย่างไร? หากเราป้อนเพียงแต่ข้อมูลพฤติกรรมดิบที่ปราศจากเฉลยคำตอบเข้าไป โมเดลคณิตศาสตร์จะสามารถสลายโครงสร้างเพื่อหาลายเซ็นความสอดคล้องกันเองได้หรือไม่?
เตรียมตัวมาขุดเจาะความลับเชิงวิศวกรรมนี้ร่วมกันล่วงหน้าในตอนถัดไป: “ตอนที่ 13: Unsupervised Learning (การเรียนรู้แบบไม่มีผู้สอน) — เปิดมิติการขุดค้นแพทเทิร์นและการรวมกลุ่มข้อมูลดิบที่ซ่อนเร้นโดยเครื่องจักร” คอยบันทึกคีย์เวิร์ดล่วงหน้ากันไว้ได้เลยครับวิศวกรรุ่นน้อง!