ตอนที่ 4: ความสัมพันธ์ระหว่าง AI, ML และ DL — ถอดรหัสโครงสร้างพิกัดแผนผังวงกลมซ้อนสามระดับ
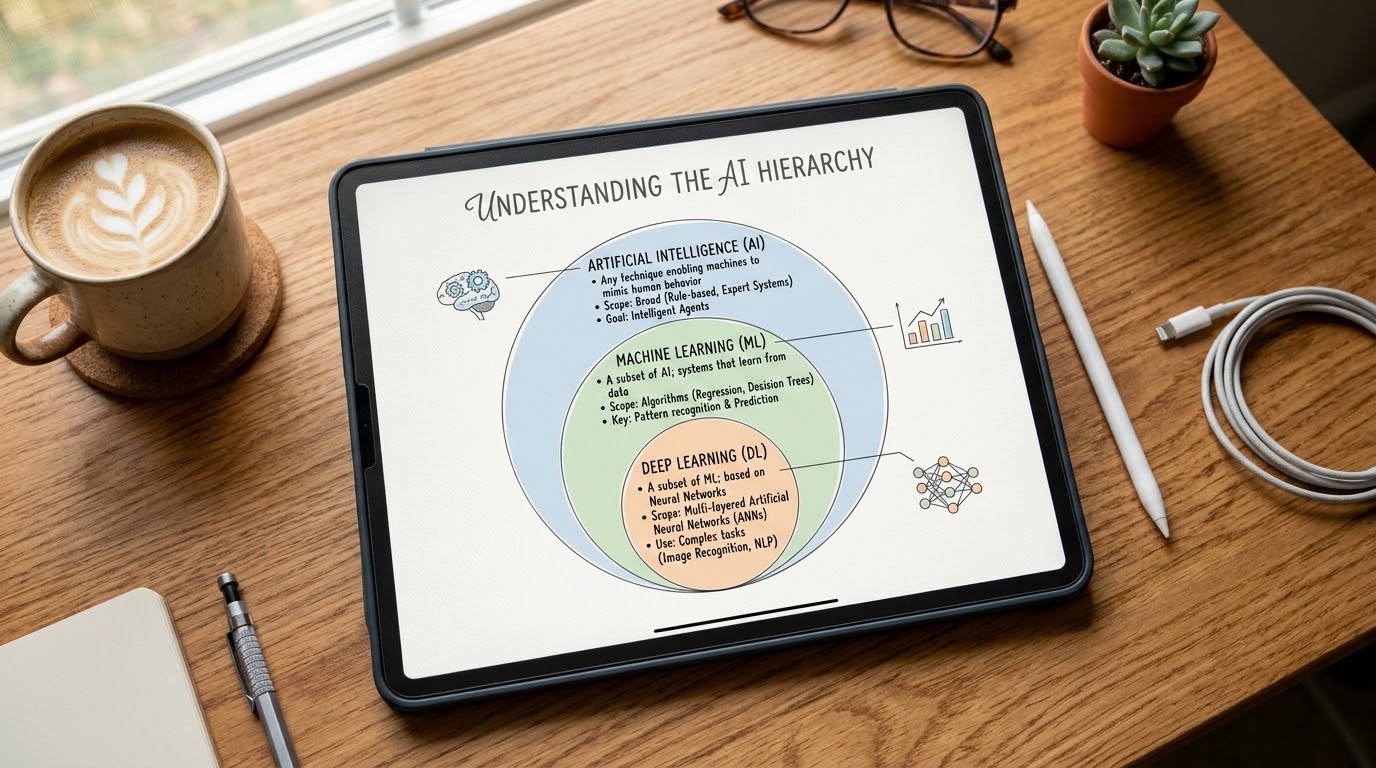
ในแวดวงการตลาดและข่าวสารด้านเทคโนโลยีในปัจจุบัน เรามักได้ยินคำว่า “AI”, “Machine Learning” และ “Deep Learning” ถูกใช้สลับกันไปมาประหนึ่งว่ามันคือสิ่งเดียวกันเป๊ะ แต่สำหรับเหล่านักพัฒนาและวิศวกรปัญญาประดิษฐ์ที่ต้องลงมือควบคุมโปรเจกต์อุตสาหกรรมจริง การไม่เข้าใจรอยต่อและขอบเขตที่แท้จริงของคำศัพท์เหล่านี้ อาจนำไปสู่สภาวะ “หลงทิศทางของการเลือกใช้เทคโนโลยี” ได้ครับ
ลองนึกถึงปัญหาคลาสสิกในไลน์ผลิต เช่น ผู้บริหารระดับสูงเดินมาบอกทีมวิศวกรว่า “เราต้องใช้เทคโนโลยี Deep Learning (DL) ขั้นสูง เพื่อตรวจจับระดับน้ำกลั่นในแบตเตอรี่ในโรงงานของเรา!” หากวิศวกรขาดวิสัยทัศน์ในเรื่องขอบเขตความเหมาะสมของสถาปัตยกรรม คุณอาจต้องลงจบด้วยการเสียเวลานับเดือนไปกับการกว้านซื้อกราฟิกการ์ด (GPUs) ราคาแสนแพง ติดกล้องระดับอุตสาหกรรม และเขียนโค้ด Neural Network อันซับซ้อน เพียงเพื่อแก้ปัญหาที่จริงๆ แล้วสามารถเขียนโปรแกรมกฎ Boolean Logic หรือ Classical ML สองสามคอลัมน์ก็กรองได้ถูกต้อง 100%
วันนี้พี่วิศวกร AI รุ่นพี่จะพาน้องๆ มาจิบกาแฟและกางแผนผังความสัมพันธ์ (Venn Diagram) สากล เพื่อสางโครงสร้างของพิกัดปัญญาประดิษฐ์ทั้งสามระดับนี้ให้กระจ่างชัดกันครับ!
🧠 ทฤษฎีและหลักการเบื้องหลัง (Theoretical Framework)
เพื่อป้องกันความสับสนเชิงนิยาม เราสามารถจัดระเบียบโครงสร้างความสัมพันธ์ในรูปแบบ “วงกลมซ้อนซับ (Nested Circles)” โดยมี Artificial Intelligence (AI) เป็นอาณาเขตรัศมีวงนอกสุด ครอบคลุม Machine Learning (ML) เป็นวงชั้นกลาง และมี Deep Learning (DL) เป็นแกนกลางชั้นในสุด
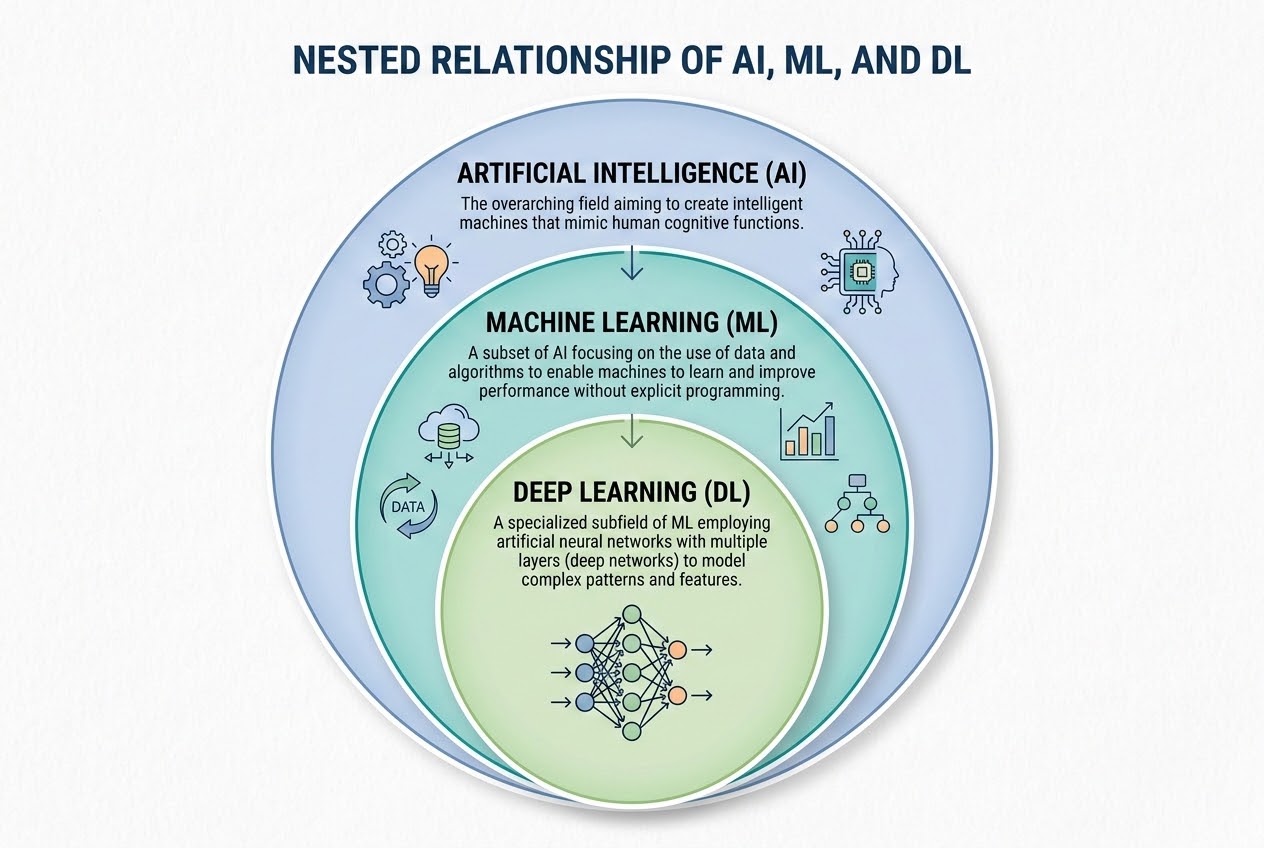
1. Artificial Intelligence (AI): ร่มใหญ่แห่งความพยายามเลียนแบบสติปัญญา
- นิยามเชิงปฏิบัติ: AI คือขอบข่ายวิชาการระดับมหภาคในวิทยาศาสตร์คอมพิวเตอร์ที่มุ่งเน้นการสร้างระบบหรือฮาร์ดแวร์ที่สามารถตอบสนอง, คำนวณ, วางแผน หรือกระทำภารกิจที่ปกติต้องอาศัยระดับสติปัญญาและความเฉลียวฉลาดของมนุษย์
- เทคโนโลยียุคแรกเริ่ม: ในช่วงปี 1950 - 1980 วงการ AI ได้รับการขับเคลื่อนด้วยแนวคิด Symbolic AI หรือ Traditional AI ที่มนุษย์พยายามจัดเก็บความรู้ของผู้เชี่ยวชาญ (Expert Systems) ออกมาเป็นสมุดกฎเกณฑ์ทางตรรกศาสตร์แข็งตัวในสไตล์ IF-THEN ขนาดยักษ์นับพันนับหมื่นข้อ
- ตัวอย่างเชิงระบบ: เครื่องคิดเลขอัจฉริยะ, บอทเดินหมากรุกที่คำนวณสเตตัสการเดินล่วงหน้าตามอัลกอริทึมต้นไม้ตัดสินใจที่มนุษย์เขียนกฎล็อคไว้ตายตัว (ไม่มีการเรียนรู้จากข้อมูลใหม่)
2. Machine Learning (ML): ยุคขับเคลื่อนทางสถิติและการเรียนรู้ผ่านประสบการณ์
- นิยามเชิงปฏิบัติ: เป็นซับเซตที่จำเพาะเจาะจงลงมาภายใต้ AI แทนที่จะใช้วิธีนำเงื่อนไข IF-THEN ที่เขียนจากสมองมนุษย์ไปบังคับคอมพิวเตอร์ตรงๆ ML กลับเลือกใช้อัลกอริทึมทางสถิติเพื่อเรียนรู้ชุดความสัมพันธ์และแพทเทิร์นที่ซ่อนอยู่ในข้อมูลดิบ (Data) เพื่อสร้างเป็นกฎเกณฑ์การตัดสินใจหรือ “โมเดล (Model)” ขึ้นมาได้ด้วยตัวมันเอง
- สถาปัตยกรรมคลาสสิก: ในชั้นของ ML จะเน้นไปที่อัลกอริทึมสถิติสายคลาสสิก (Classical Machine Learning) เช่น Linear/Logistic Regression, Decision Trees, Random Forests, Support Vector Machines (SVMs) และ Unsupervised Clustering เช่น K-Means ซึ่งต้องการคุณสมบัติจัดระเบียบข้อมูลที่มีโครงสร้างดี (Structured Data/Tabular Data)
- ตัวอย่างเชิงระบบ: ระบบจัดแนะสินค้า (Product Recommendations) ของ Netflix หรือ Amazon ที่เรียนรู้จากการกดไลก์ ประวัติการรับชม และพฤติกรรมในอดีตของผู้ใช้นับล้านรายเพื่อทำนายความต้องการถัดไป
3. Deep Learning (DL): เทคโนโลยีสกัดฟีเจอร์อัตโนมัติด้วยโครงข่ายใยประสาท
- นิยามเชิงปฏิบัติ: เป็นสาขาย่อยจำเพาะภายใต้ร่มเงาของ Machine Learning อีกทีหนึ่ง โดยใช้โครงสร้างที่จำลองแนวคิดมาจากสมองมนุษย์ที่เรียกว่า โครงข่ายประสาทเทียมหลายชั้นเลเยอร์ (Deep Artificial Neural Networks)
- การปฏิวัติฟีเจอร์เด่น: จุดตัดขาดสำคัญระหว่าง ML คลาสสิกกับ Deep Learning คือ เรื่อง Feature Engineering ครับ ในขณะที่ ML คลาสสิกต้องการมนุษย์มาช่วยคัดเลือก สกัด และแปลงค่าตัวแปร (เช่น การวัดขนาดหน้าแอปเปิล สเปกสี) โครงสร้างระดับ “ลึก (Deep)” ของ DL ที่ซ้อนทับกันหลายสิบหลายร้อยเลเยอร์จะทำการสกัดและเรียนรู้คุณลักษณะเด่นเหล่านั้นจากข้อมูลดิบโดยตรงได้เองอัตโนมัติ (Representation Learning)
- ตัวอย่างเชิงระบบ: ระบบกล้องรถยนต์ไร้คนขับ (Autonomous Driving) เช่น Tesla ที่ต้องแยกแยะคนเดินเท้า ป้ายจำกัดความเร็ว และเสาไฟฟ้าจากพิกเซลรูปภาพดิบกลางสายฝน ซึ่งมีความท้าทายและความกว้างของมิติข้อมูลสูงเกินกว่าที่โมเดลสถิติทั่วไปจะเข้าถึงได้
🏭 ตารางสรุปเปรียบเทียบและการประยุกต์ใช้ในอุตสาหกรรม
เพื่อให้เห็นถึงการทำงานร่วมกัน ลองเปรียบเทียบในกรณีศึกษาของ “ระบบตรวจสอบคุณภาพชิ้นงานเหล็กสะท้อนแสงในสายพานการผลิต”:
| คุณลักษณะ (Features) | ระดับที่ 1: Traditional AI | ระดับที่ 2: Classical Machine Learning | ระดับที่ 3: Deep Learning (DL) |
|---|---|---|---|
| แนวทางการทำงาน | ใช้กฎเชิงตรรกศาสตร์ที่มนุษย์เขียนขึ้นมาเพื่อกำหนดความเข้มของแสงสะท้อน | ใช้โมเดลคณิตศาสตร์เรียนรู้ค่าพารามิเตอร์เชิงตัวเลขจากประวัติศาสตร์ข้อมูล | ใช้โครงข่ายใยประสาท (Neural Network) เพื่อสกัดโครงสร้างภาพและทำนายผล |
| ข้อมูลป้อนเข้า (Inputs) | ค่าตัวเลขค่า Grayscale และขนาดความกว้างแบบตายตัว | ชุดตารางตัวเลขลักษณะทางฟิสิกส์ (Features) ที่ผ่านการคัดสรรโดยวิศวกร | ข้อมูลรูปภาพพิกเซลดิบ (Raw Image Pixels) จากกล้อง Machine Vision โดยตรง |
| ขีดความสามารถ | คัดกรองแม่นยำ 100% ในสภาพควบคุมคงที่ แต่เปราะบางมากหากจัดวางตำแหน่งเปลี่ยนไป | ตรวจสอบชิ้นงานได้อย่างมั่นคง ยืดหยุ่นได้เมื่อคุณสมบัติโครงสร้างภายนอกขยับขึ้นลง | จัดการกับสภาพแวดล้อมที่คาดเดาไม่ได้ (แสงเปลี่ยน ทิศทางภาพหมุน ตนเองขยับกล้อง) |
| ตัวอย่างเครื่องมือ | IF-THEN Rules, Expert System rule engine | Scikit-learn (Logistic Regression, Decision Trees) | TensorFlow, Keras, PyTorch (Convolutional Neural Network) |
🛠️ ขั้นตอนการทดลองและติดตั้ง (Implementation Guide)
เพื่อให้นักพัฒนาปัญญาประดิษฐ์มองเห็นภาพความสัมพันธ์และการส่งต่อระบบอย่างเป็นวิศวกรรมสากล เรามาทดลองเขียนสคริปต์จำลองการคัดแยกเกรดแผงวงจรชำรุด (PCB Grader) 3 รูปแบบในไฟล์เดียวกัน เพื่อวิเคราะห์ระดับผลลัพธ์และความแตกต่างกันครับ:
import numpy as np
from sklearn.ensemble import RandomForestClassifier
import tensorflow as tf
from tensorflow.keras import layers, models
# =====================================================================
# 1. ข้อมูลนำเข้าดิบ (Raw Data)
# คุณลักษณะ: [ความกว้างช่องตัด (มม.), อุณหภูมิการทำงาน (C)]
# =====================================================================
X_pcb_features = np.array([
[5.0, 45.0], [5.1, 48.0], [4.8, 85.0], [5.2, 47.0], [4.9, 90.0],
[5.0, 46.0], [5.3, 44.0], [4.7, 95.0], [5.1, 45.0], [4.6, 99.0]
])
# เฉลยเกรดชิ้นงาน: 1 = เกรดพรีเมียม (Passed), 0 = มีอุณหภูมิเกินขีดจำกัด/พัง (Rejected)
y_pcb_labels = np.array([1, 1, 0, 1, 0, 1, 0, 0, 1, 0])
# =====================================================================
# ระดับที่ 1: Traditional AI Approach (Rule-Based Logic)
# มนุษย์เป็นผู้กำหนดกฎเกณฑ์ชัดเจนจากความเชี่ยวชาญ
# =====================================================================
def rule_based_ai_grader(pcb_data):
predictions = []
for item in pcb_data:
width, temp = item[0], item[1]
# กำหนดเกณฑ์โดยใช้สมองมนุษย์คาดคะเน
if temp < 70.0 and (4.9 <= width <= 5.2):
predictions.append(1) # Passed
else:
predictions.append(0) # Rejected
return np.array(predictions)
# =====================================================================
# ระดับที่ 2: Classical Machine Learning (Scikit-Learn Random Forest)
# ให้คอมพิวเตอร์เรียนรู้พารามิเตอร์คณิตศาสตร์และปรับโครงสร้างตัดสินใจจากตารางข้อมูล
# =====================================================================
ml_classifier = RandomForestClassifier(n_estimators=10, random_state=42)
ml_classifier.fit(X_pcb_features, y_pcb_labels)
# =====================================================================
# ระดับที่ 3: Deep Learning (TensorFlow/Keras Neural Network)
# ใช้โครงสร้างใยประสาทที่ซับซ้อน ปล่อยให้ระบบขยับปรับ Weights เพื่อสลายโครงสร้างข้อมูล
# =====================================================================
dl_model = models.Sequential([
layers.Input(shape=(2,)),
layers.Dense(8, activation='relu'), # Hidden Layer 1
layers.Dense(4, activation='relu'), # Hidden Layer 2
layers.Dense(1, activation='sigmoid') # Output Layer สำหรับจำแนก 0 หรือ 1
])
dl_model.compile(optimizer='adam', loss='binary_crossentropy', metrics=['accuracy'])
# รันรอบฝึกสอนกระชับสั้น 10 epochs
dl_model.fit(X_pcb_features, y_pcb_labels, epochs=10, batch_size=2, verbose=0)
# =====================================================================
# 🔍 แสดงผลและวิเคราะห์ผลลัพธ์การทำงานร่วมกัน
# =====================================================================
new_test_pcb = np.array([[5.0, 88.0]]) # ชิ้นงานใหม่: อุณหภูมิพุ่งสูงถึง 88 องศา (ควร Rejected!)
print("--- เปรียบเทียบการประเมินผล PCB จาก 3 เทคโนโลยี ---")
print(f"1. Traditional AI (Rule-Based) คาดทำนายเกรด: {rule_based_ai_grader(new_test_pcb)}")
print(f"2. Classical ML (Random Forest) คาดทำนายเกรด: {ml_classifier.predict(new_test_pcb)}")
print(f"3. Deep Learning (ANN Model) ทำนายเปอร์เซ็นต์ผ่าน: {dl_model.predict(new_test_pcb, verbose=0).flatten()[0]:.4f}")⚠️ ข้อควรระวังและแนวทางปฏิบัติที่ดีที่สุด (Pitfalls & Best Practices)
The Over-Engineering Trap (หลุมพรางการทุ่มเทเทคโนโลยีเกินความจริง): อย่าเพิ่งเหมารวมว่าโมเดลที่อยู่ชั้นในสุดอย่าง Deep Learning จะให้คำตอบที่ดีที่สุดสำหรับทุกคำถามเสมอนะครับ! โครงข่ายประสาทต้องการประสบการณ์ข้อมูลดิบที่มหาศาลและใช้พลังงานประมวลผลสูงมาก หากโจทย์วิเคราะห์ข้อมูลของคุณอยู่ในรูปแบบดาต้าเบสแบบตาราง (Tabular data) การนำอัลกอริทึมคลาสสิกของ ML เช่น XGBoost หรือ Random Forest จากคลัง Scikit-learn มาเทรนจะให้ผลลัพธ์ที่รวดเร็ว ลื่นไหล และเสถียรกว่าการป้อนข้อมูลให้แบบจำลอง DL หลายเท่าครับ
The Right Tool for the Right Job:
- ใช้ Traditional AI (Rule-based) เมื่อกฎเกณฑ์ของธุรกิจมีความเด่นชัดและไม่มีการแกว่งตัวตามสภาพแวดล้อม เช่น อัตราคิดเงินค่าล่วงเวลา หรือการสับเปลี่ยนสวิตช์ความปลอดภัย
- ใช้ Classical Machine Learning เมื่อข้อมูลถูกจัดมาในแบบตาราง มีจำนวนแถวน้อยกว่าสองหมื่นรายการ และต้องการความโปร่งใสในการตรวจสอบ (Explainability)
- ใช้ Deep Learning เมื่อคุณต้องจัดการข้อมูลที่ซับซ้อน ไร้ระเบียบ เช่น เสียงพูดของพนักงาน, ภาพพ่นสีสินค้า และมีเป้าหมายในการให้โมเดลหาสิ่งผิดปกติด้วยตัวมันเองโดยที่วิศวกรไม่ต้องเข้ามาเขียนฟิลเตอร์สกัดรูปภาพด้วยมือ
📝 บทสรุปและสเกลถัดไป (Conclusion & Next Steps)
การเข้าใจถึงการทับซ้อนและความสัมพันธ์ของแผนผัง AI, ML และ DL ช่วยให้คุณมีวิสัยทัศน์ในระดับสถาปนิกปัญญาประดิษฐ์ สามารถเลือกสรรหยิบจับอาวุธที่ถูกต้องไปพิชิตโจทย์ปัญหาระดับอุตสาหกรรมได้อย่างชาญฉลาดและเฉียบคมที่สุดครับ!
ในบทความบทหน้า เราจะก้าวข้ามจากปฐมบททฤษฎีพื้นฐานของวงกลมทั้งสามสีนี้ เข้าสู่กระบวนการที่แท้จริงของการจัดทำท่อระบายข้อมูลและการจัดการดาต้าเซ็ตด้วยไลบรารีขั้นเทพของแวดวงอุตสาหกรรมปัญญาประดิษฐ์ในชื่อ “ตอนที่ 5: ประวัติศาสตร์และวิวัฒนาการของ ML” อย่าลืมติดตามอ่านและทบทวนคีย์เวิร์ดล่วงหน้ากันนะครับ!