ตอนที่ 2: นิยามที่แท้จริงของ Machine Learning — จากสมการคณิตศาสตร์สู่ประสบการณ์ที่เครื่องเรียนรู้ได้เอง
ในฐานะวิศวกรโรงงาน คุณเคยได้รับคำสั่งประเภทนี้ไหมครับ? “ช่วยปรับแต่งระบบตรวจจับหัวน็อตที่ไม่ได้มาตรฐานในไลน์ผลิตหน่อย ช่วงนี้ซัพพลายเออร์เปลี่ยนเจ้าเหล็กที่ใช้ทำน็อตมันเลยสะท้อนแสงเปลี่ยนไปนิดหน่อย พนักงานบ่นว่ากล้องมันทายพลาดเยอะมาก!”
ถ้าเป็นโปรแกรมมิ่งยุคเก่า คุณคงต้องปีนขึ้นไปบนโครงเหล็ก ถือประแจไปปรับตำแหน่งกล้อง หรือไม่ก็ต้องมาเปิดโค้ดเพื่อ Hardcode ปรับค่าเกณฑ์สีเทา (Grayscale Threshold) ใหม่ทีละค่าทีละคอลัมน์ พรุ่งนี้พอแสงเปลี่ยนหรือเปลี่ยนล็อตการผลิต ระบบก็พังอีกวนลูปไม่รู้จบ
แต่ในโลกของ Machine Learning เราจะบอกเจ้าคอมพิวเตอร์ว่า “นี่คือรูปหัวน็อตดี 5,000 รูป และนี่คือรูปหัวน็อตเบี้ยวที่ถ่ายจากกล้องจริง 5,000 รูป เอ็งจงไปหาความแตกต่างและสร้างสูตรตรวจสอบเอาเองนะ!” วันนี้พี่จะพาจิบกาแฟและมาขุดคุ้ยความหมายลึกๆ ของประโยคนี้กันครับ ว่าเจ้าโมเดลตัวเลขมัน “กิน” ข้อมูลเข้าไปแล้วมัน “ฉลาดขึ้น” ได้อย่างไรกันแน่
🧠 ทฤษฎีและหลักการเบื้องหลัง (Theoretical Framework)
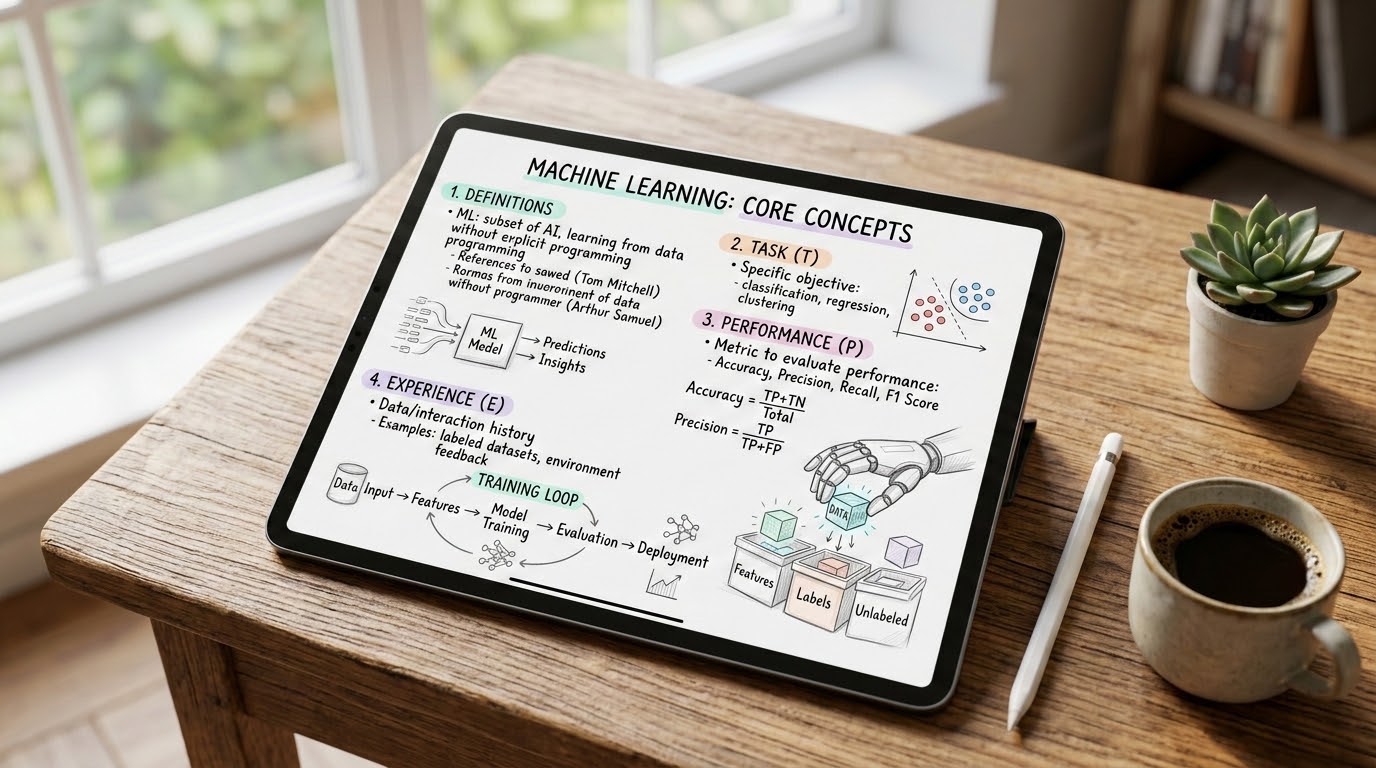
คำว่า “Machine Learning” ถูกนิยามไว้ครั้งแรกอย่างเป็นทางการโดย Arthur Samuel บิดาแห่งวงการเกมคอมพิวเตอร์และปัญญาประดิษฐ์ในปี 1959 ในระหว่างที่เขาพยายามสอนคอมพิวเตอร์ให้เล่นหมากฮอส (Checkers) เอาชนะมนุษย์ให้ได้ เขาได้ให้คำนิยามสุดคลาสสิกไว้ว่า:
“Machine Learning คือการศึกษาวิจัยเพื่อทำให้คอมพิวเตอร์มีความสามารถในการเรียนรู้ได้ด้วยตนเอง โดยไม่ต้องอาศัยการเขียนคำสั่งควบคุม (Explicit Programming) จากมนุษย์โดยตรง”
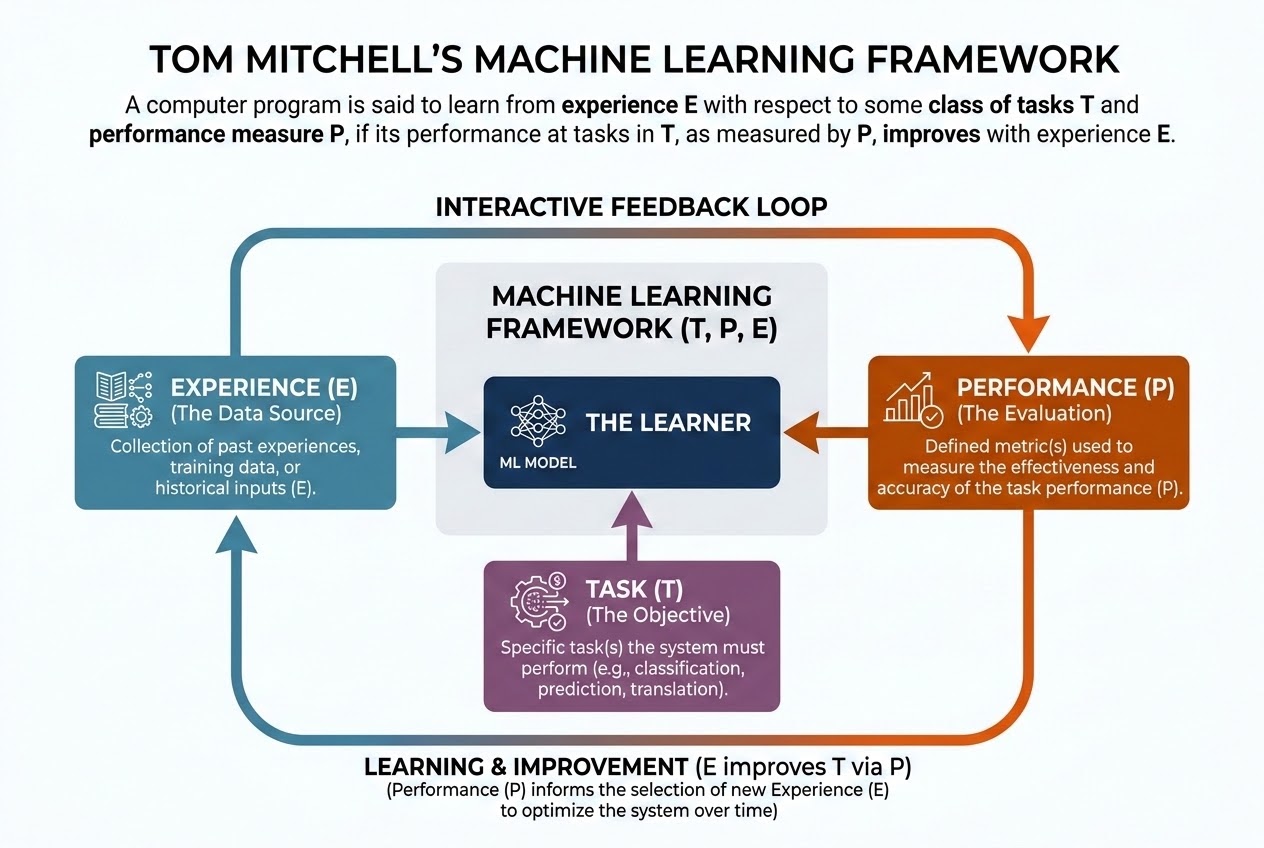
ต่อมาในปี 1997 Tom Mitchell นักวิทยาศาสตร์คอมพิวเตอร์ผู้เขียนตำรา Machine Learning ระดับสากล ได้ยกระดับคำนิยามนี้ให้กลายเป็น “สมการเชิงวิศวกรรม” ที่เราสามารถใช้วัดผลและนำไปเขียนโปรแกรมได้จริงผ่านกฎเหล็ก T-P-E:
สูตรสำเร็จ 3 องค์ประกอบในการเรียนรู้ (Tom Mitchell’s Formulation): โปรแกรมคอมพิวเตอร์จะถูกเรียกได้ว่าเกิดการ “เรียนรู้” จาก ประสบการณ์ E (Experience) ที่เกี่ยวข้องกับ งาน T (Task) และการวัดค่าประสิทธิภาพ P (Performance) ก็ต่อเมื่อ ประสิทธิภาพการทำงานในงาน T (ที่วัดด้วยค่า P) มีการพัฒนาปรับปรุงดีขึ้นเรื่อยๆ จากการสะสมประสบการณ์ E
เพื่อให้เห็นภาพชัดเจนที่สุด ลองนำนิยามของ Tom Mitchell มาเปรียบเทียบในเชิงปฏิบัติดังนี้ครับ:
| ตัวอย่างสถานการณ์จริง | งาน (Task - T) | ประสิทธิภาพ (Performance - P) | ประสบการณ์ (Experience - E) |
|---|---|---|---|
| ระบบกรองอีเมลขยะ (Spam Filter) | คัดแยกและจัดหมวดหมู่อีเมลว่าเป็น “Spam” หรือ “Inbox” | เปอร์เซ็นต์ความถูกต้องในการกรองขยะ (Accuracy) | ประวัติการกดคลิกทำเครื่องหมาย “Spam/Not Spam” ของผู้ใช้ในอดีต |
| ระบบกล้องคัดแยกเกรดแอปเปิล | ตรวจจำแนกภาพถ่ายแอปเปิลเป็น “Premium” หรือ “Regular” | อัตราความแม่นยำในการคัดแยกผลไม้ผิดพลาด (Error Rate) | คลังรูปภาพแอปเปิลจำนวนมหาศาลที่ผ่านการตรวจสอบและเฉลยคำตอบโดยผู้เชี่ยวชาญ |
| โมเดลรถยนต์ไร้คนขับ (Autonomous Car) | การควบคุมทิศทางพวงมาลัยและเบรกบนท้องถนน | ระยะทางที่วิ่งได้ปลอดภัยโดยที่มนุษย์ไม่ต้องเข้าควบคุมแทรกแซง | การโต้ตอบกับสภาพแวดล้อมจำลอง (Trial and Error) และการรับคะแนนรางวัลเมื่อเลี้ยวถูกเลน |
⚙️ คอมพิวเตอร์เปลี่ยนประสบการณ์เป็นปัญญาได้อย่างไร? (The Mechanics of Learning)
ในชีวิตประจำวัน มนุษย์เราเรียนรู้จากการลองผิดลองถูก คอมพิวเตอร์ก็ทำแบบเดียวกันผ่านวิชา แคลคูลัสและสถิติศาสตร์ ครับ:
- การตั้งสมมติฐานเริ่มต้น (Hypothesis & Parameters): โมเดลจะเริ่มต้นชีวิตด้วย “โครงสร้างคณิตศาสตร์พื้นฐาน” (สมมติว่าเป็นเส้นตรง $y = wx + b$) และจะมีการสุ่มตัวเลขค่าน้ำหนักเริ่มต้นที่เรียกว่า Weights ($w$) และ Biases ($b$) ขึ้นมาแบบสุ่มเดา (ณ จุดนี้ โมเดลยังเดาค่าได้ห่วยแตกมาก)
- การคำนวณหาความล้มเหลว (Loss Function): โมเดลจะนำเอาข้อมูลจากประสบการณ์ $E$ ใส่เข้าไปและพ่นคำทำนายออกมา จากนั้นระบบจะรันฟังก์ชันสูญเสียหรือ Loss Function (L) เพื่อคำนวณความแตกต่างระหว่างสิ่งที่มันทาย กับคำตอบเฉลยจริงว่าห่างไกลกันแค่ไหน
- การปรับจูนตัวแปรทางคณิตศาสตร์ (Optimization & Weight Update): โมเดลจะใช้กระบวนการคำนวณทางคณิตศาสตร์เพื่อหาทาง “ปรับลดค่าความสูญเสียให้เหลือน้อยที่สุด” (เรียกว่า Empirical Risk Minimization) โดยค่อยๆ ทยอยขยับปรับค่าพลังงาน $w$ และ $b$ ทีละนิดเพื่ออุดช่องโหว่ความคลาดเคลื่อนนั้น
- สร้างทักษะการทำนายโจทย์ใหม่ (Generalization): เมื่อมันวนลูปเทรน (Training Phase) ซ้ำไปเรื่อยๆ จนค่าความเอเรอร์ลดต่ำลงในระดับที่น่าพึงพอใจ โมเดลจะสามารถนำเอาชุดพารามิเตอร์ $w$ และ $b$ ตัวล่าสุดไปใช้ทำนายผลข้อมูลชุดใหม่เอี่ยมที่ไม่เคยเห็นตอนเรียน (Test Set) ได้อย่างถูกต้อง ซึ่งเราเรียกความสามารถอันทรงคุณค่านี้ว่า “Generalization” (ความสามารถในการคาดการณ์อย่างยืดหยุ่น)
🛠️ ขั้นตอนการทดลองและติดตั้ง (Implementation Guide)
เพื่อพิสูจน์นิยามของ Tom Mitchell เราลองมารันโค้ด Python เพื่อสร้างโปรแกรมเรียนรู้อัตโนมัติจากข้อมูลเชิงตัวเลขจำลองกันครับ โดยเราจะใช้ระบบสร้างประสบการณ์ ($E$) เพื่อพัฒนาแบบจำลองตรวจจับหัวน็อตชำรุด ($T$) และทดสอบค่าคะแนนความถูกต้อง ($P$):
import numpy as np
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score
# =====================================================================
# 1. จัดเตรียม "ประสบการณ์" (Experience - E) จากประวัติศาสตร์ข้อมูล
# คุณลักษณะ (Features): [ความกว้างของน็อต (มม.), ความมันวาวของการสะท้อนแสง (0.0 - 1.0)]
# =====================================================================
X_screw_features = np.array([
[10.2, 0.85], [10.1, 0.79], [9.8, 0.40], [10.3, 0.88], [9.9, 0.35],
[10.0, 0.81], [10.4, 0.92], [9.7, 0.20], [10.2, 0.84], [9.6, 0.15],
[10.1, 0.80], [9.9, 0.42], [10.3, 0.89], [9.8, 0.30], [10.0, 0.83],
[10.2, 0.86], [9.5, 0.10], [10.1, 0.78], [9.9, 0.45], [10.4, 0.91]
])
# เฉลยเกรดชิ้นงาน (0 = ชำรุด/Rejected, 1 = ผ่านมาตรฐาน/Passed)
y_screw_labels = np.array([
1, 1, 0, 1, 0,
1, 1, 0, 1, 0,
1, 0, 1, 0, 1,
1, 0, 1, 0, 1
])
# แยกข้อมูลเพื่อเอาไปใช้ตอนทดสอบเปรียบเทียบในห้องสอบจริง (Train/Test Split)
X_train, X_test, y_train, y_test = train_test_split(
X_screw_features, y_screw_labels, test_size=0.3, random_state=42
)
# =====================================================================
# 2. จัดเตรียม "งาน" (Task - T) และเริ่มขั้นตอนกระบวนการเรียนรู้
# =====================================================================
# เราเลือกใช้โมเดลโครงสร้าง Logistic Regression (ซึ่งมีค่าพารามิเตอร์ด้านในที่รอปรับจูน)
model = LogisticRegression()
# คอมพิวเตอร์ทำการเรียนรู้เพื่อปรับจูนค่าน้ำหนักจากประวัติศาสตร์ข้อมูลฝึกสอน (Training Process)
model.fit(X_train, y_train)
# =====================================================================
# 3. ตรวจวัดระดับการพัฒนา "ประสิทธิภาพ" (Performance - P)
# =====================================================================
# ให้โมเดลลองทำข้อสอบชุดทดสอบที่ไม่เคยเห็นมาก่อนในขั้นตอนการเรียนรู้
y_predictions = model.predict(X_test)
# คำนวณหาค่าประสิทธิภาพ P ในรูปแบบของความถูกต้อง (Accuracy Score)
performance_p = accuracy_score(y_test, y_predictions)
# สกัดค่าน้ำหนักที่เครื่องแอบคำนวณได้เอง
print("--- สรุปผลการสกัดคุณลักษณะและการค้นพบสูตรตัดสินใจโดยเครื่อง ---")
print(f"ค่าพารามิเตอร์ค่าน้ำหนัก (Weights - w) ที่เรียนรู้ได้เอง: {model.coef_}")
print(f"ค่าสัมประสิทธิ์ส่วนเบี่ยงเบน (Bias - b): {model.intercept_[0]:.4f}")
print(f"คะแนนประสิทธิภาพการเรียนรู้ (Performance P): {performance_p * 100:.2f}%")⚠️ ข้อควรระวังและแนวทางปฏิบัติที่ดีที่สุด (Pitfalls & Best Practices)
The Illusion of Memorization (หลุมพรางของการท่องจำ): ระวังจุดผิดพลาดที่พบบ่อยของมือใหม่ครับ! โมเดลที่ฉลาดและสอบได้คะแนนเต็ม 100% บนข้อมูลที่เทรนมา (Train Error = 0) อาจกลายเป็นโมเดลที่โง่เขลาในชีวิตจริงได้หากมันทำการ “ท่องจำข้อสอบจำเพาะ” (Overfitting / Rote Learning). โมเดลที่ดีที่สุดไม่ใช่โมเดลที่ท่องจำเก่ง แต่ต้องเป็นโมเดลที่มี Generalization หรือความเข้าใจในคอนเซปต์ภาพรวมเพื่อนำความรู้ไปประยุกต์ตอบคำถามกับโจทย์ใหม่ๆ ได้อย่างลื่นไหลครับ
The Value of Data Volume (ปริมาณของประสบการณ์): กลไกสถิติเบื้องหลัง Machine Learning ต้องการประสบการณ์ในรูปแบบข้อมูลดิบที่มีปริมาณมากและมีการกระจายตัวที่ดี (Representative Data). หากเราป้อนประสบการณ์ให้เครื่องเรียนรู้น้อยเกินไป มันจะสับสนและสร้างกฎเกณฑ์ที่ไม่ถูกต้องขึ้นมาได้ ดังนั้นหัวใจสำคัญของ MLOps คือการคัดสรรและป้อนข้อมูลคุณภาพสูงเพื่อสร้างประสบการณ์ที่สมบูรณ์ให้แก่แบบจำลองครับ
📝 บทสรุปและสเกลถัดไป (Conclusion & Next Steps)
Machine Learning จึงไม่ใช่เวทมนตร์หรือรหัสโค้ดอัจฉริยะลึกลับที่ไหน แต่มันคือวิศวกรรมสถิติที่นำสมการคณิตศาสตร์มาอัปเดตปรับแก้พารามิเตอร์ของตนเองซ้ำๆ ผ่านประสบการณ์ข้อมูลดิบ จนกระทั่งมันค้นพบสูตรที่เหมาะสมที่สุดในการสร้างทางลัดในการแปลงข้อมูลดิบให้กลายเป็นคำทำนายที่มีประโยชน์ต่ออุตสาหกรรมครับ
ในตอนถัดไป เราจะข้ามพรมแดนจากโมเดลคลาสสิกที่เรียนรู้ทางสถิติทั่วไป มุ่งหน้าสู่การขึงสายใยเครือข่ายจำลองสมองกลในบทความ “ตอนที่ 3: Deep Learning คืออะไร?์” อย่าลืมเตรียมถ้วยกาแฟไว้ให้พร้อม แล้วพบกันนะครับ!