ตอนที่ 5: ประวัติศาสตร์และวิวัฒนาการของ ML — จากเกมหมากฮอสสู่ชัยชนะเหนือแชมป์โลก
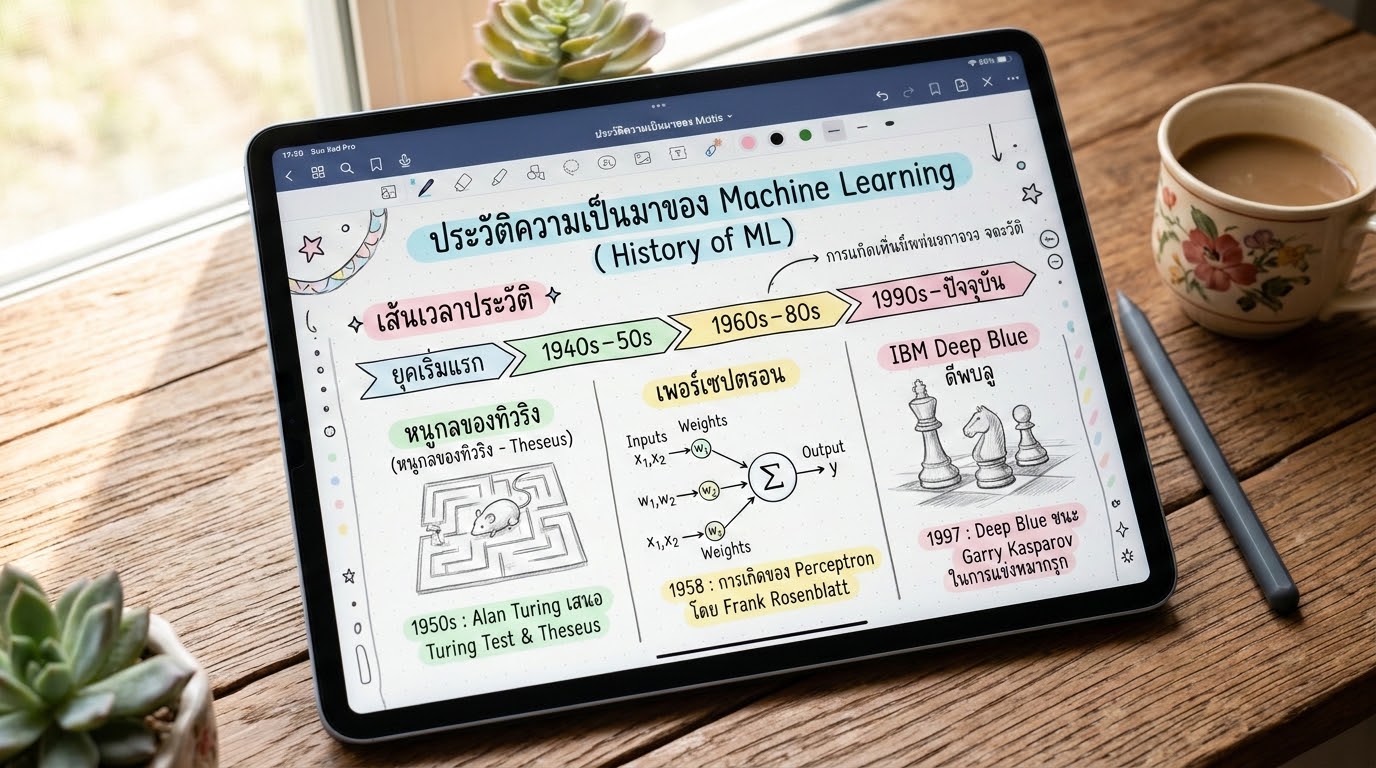
ในสายตาของคนทั่วไป เทคโนโลยีปัญญาประดิษฐ์หรือ Machine Learning (ML) อาจดูเหมือน “นวัตกรรมล้ำยุคแห่งศตวรรษที่ 21” ที่เพิ่งกำเนิดขึ้นมาพร้อมกับสมาร์ตโฟนและรถยนต์ไร้คนขับ แต่ในความเป็นจริงของเหล่านักพัฒนาและวิศวกรปัญญาประดิษฐ์ วิวัฒนาการของมันคือการต่อสู้ฝ่าฟันอันยาวนานกว่า 70 ปี ผ่านช่วงเวลาแห่งความตื่นเต้นที่เกินจริง (Hype) อุปสรรคทางคณิตศาสตร์ และยุคที่ไร้งบประมาณสนับสนุนจนเกือบต้องปิดตัวลงที่เรียกว่า AI Winter
ลองจินตนาการย้อนไปในยุค 1950s คอมพิวเตอร์เครื่องหนึ่งมีขนาดใหญ่เท่ากับตู้เย็นและมีพลังประมวลผลน้อยกว่าหน่วยประมวลผลกราฟิก (GPU) ในปัจจุบันถึง 1 แสนล้านเท่า แต่นักวิทยาศาสตร์กลุ่มเล็กๆ กลับเชื่อมั่นว่าเราสามารถ “สร้างมันสมองจำลอง” ขึ้นมาจากหลอดสูญญากาศและระบบสถิติได้ วันนี้พี่วิศวกร AI จะพามาเปิดหน้าประวัติศาสตร์ จิบกาแฟ และเรียนรู้ไปพร้อมๆ กันว่าคอมพิวเตอร์เอาชนะข้อจำกัดเหล่านั้นขึ้นมาเป็นสมองกลระดับพระกาฬได้อย่างไรครับ!
🧠 ทฤษฎีและหลักการเบื้องหลัง (Theoretical Framework)
ประวัติศาสตร์และวิวัฒนาการของ Machine Learning สามารถแบ่งหมวดหมู่และสรุปตามเหตุการณ์สำคัญ (Key Milestones) ได้เป็น 5 ยุคหลักๆ ดังนี้ครับ:
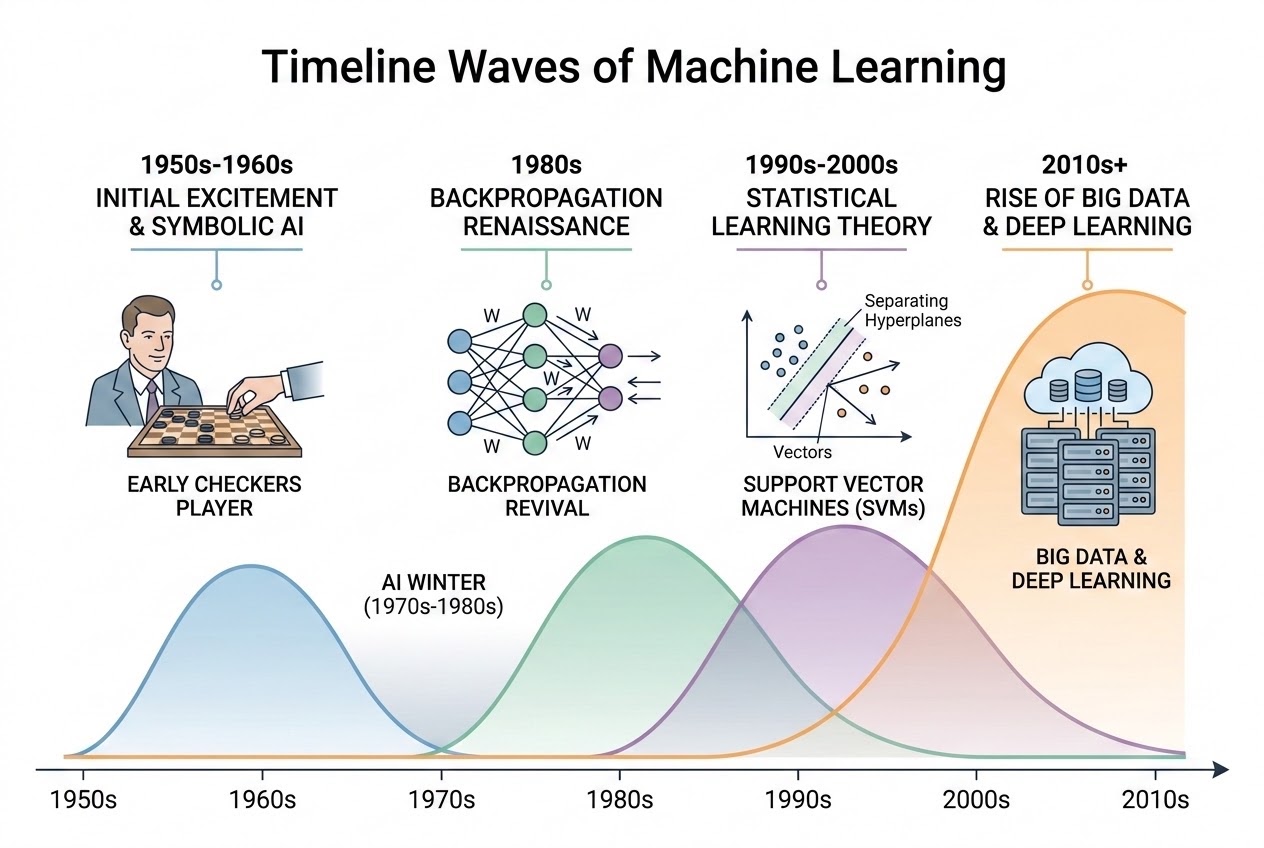
⏳ 1. ปฐมบทแห่งความพยายามและโมเดลแรกเริ่ม (1940s - 1950s)
- 1943 - จุดกำเนิดเซลล์ประสาทเทียมตัวแรก (The McCulloch-Pitts Neuron): แพทย์ระบบประสาท Warren McCulloch และนักคณิตศาสตร์ Walter Pitts ได้สร้างโมเดลคณิตศาสตร์จำลองเซลล์ประสาทขึ้นมาเป็นครั้งแรกในชื่อ Threshold Logic Unit (TLU) เพื่อพิสูจน์ว่าเครือข่ายประสาทอย่างง่ายสามารถคำนวณตรรกศาสตร์ขั้นพื้นฐานได้ (เช่น AND และ OR) แต่มันยังมีข้อจำกัดอย่างยิ่งยวดคือ “ไม่มีกลไกเรียนรู้” มนุษย์ต้องคัดเลือกและป้อนค่าน้ำหนัก (Weights) ด้วยมือเองทั้งหมด
- 1950 - นวัตกรรมการเรียนรู้ในมุมมองของ Alan Turing: อลัน ทัวริง บิดาแห่งวิทยาศาสตร์คอมพิวเตอร์ ได้เขียนบทความเสนอแนวคิด “เครื่องจักรที่สามารถเรียนรู้เองได้” (Learning Machine) โดยจำลองกระบวนการให้รางวัลและการลงโทษ (Pleasure-Pain/Punishment-Reward System) เพื่อปรับเปลี่ยนตารางคำสั่งภายในตัวเครื่อง ซึ่งกลายเป็นรากฐานสำคัญของศาสตร์ Reinforcement Learning ในเวลาต่อมา
- 1952/1959 - อักษรย่อ “ML” และตรวจสอบชัยชนะของ Arthur Samuel: อาร์เทอร์ แซมมวล วิศวกรแห่ง IBM ได้คิดค้นโปรแกรม “เล่นเกมหมากฮอสเรียนรู้ได้ด้วยตนเอง” (Self-learning Checkers Program) บนเครื่องคอมพิวเตอร์ IBM 701 และเป็นผู้บัญญัติคำว่า “Machine Learning” ขึ้นเป็นครั้งแรกในปี 1959 โดยโปรแกรมของเขาสามารถทบทวนความน่าจะเป็นในการชนะ-แพ้จากตารางหมากฮอส จนกระทั่งมันสามารถลงแข่งขันชนะนักเล่นมืออาชีพและชนะตัวผู้เขียนโปรแกรมเองได้ในที่สุด!
- 1957/1958 - กำเนิดเครื่องกลแห่งการจดจำ (The Rosenblatt’s Perceptron): แฟรงก์ โรเซนแบลตต์ แห่ง Cornell Aeronautical Laboratory ได้นำเสนอโมเดล Perceptron ซึ่งเป็นโครงข่ายประสาทเทียม 2 เลเยอร์ที่สามารถ “ปรับจูนค่าน้ำหนัก (Weights) ได้เองอัตโนมัติ” ตามข้อผิดพลาดของการทำนาย และสร้างมันขึ้นมาในรูปแบบเครื่องกลไฟฟ้าชื่อ Mark I Perceptron ที่ใช้กล้อง 400 โฟโตเซลล์ และปรับค่าน้ำหนักผ่านมอเตอร์ไฟฟ้าหมุนตัวต้านทาน (Potentiometers) นับเป็นหมุดหมายที่ปลุกกระแสความตื่นตัวไปทั่วโลก
❄️ 2. อุปสรรคทางคณิตศาสตร์และจุดเยือกแข็งครั้งที่หนึ่ง (1960s - 1970s)
- 1960 - ADALINE และการประมวลผลเชิงลาด: Bernard Widrow และ Marcian Hoff ได้ปรับปรุงการเรียนรู้ของ Perceptron โดยใช้หลักการหาความชัน (Gradient Descent) ในชื่อ ADALINE (Adaptive Linear Neuron) ซึ่งเป็นต้นแบบที่สำคัญของอัลกอริทึมการเพิ่มประสิทธิภาพในปัจจุบัน
- 1969 - สมุดมรณะของเพอร์เซปตรอน (The Minsky & Papert Roadblock): มาร์วิน มินสกี และ ซีมัวร์ พาเพิร์ต ได้ตีพิมพ์หนังสือวิเคราะห์เชิงลึกชื่อ “Perceptrons” พวกเขาพิสูจน์ทางคณิตศาสตร์ว่าโมเดล Perceptron แบบชั้นเดียว (Single-layer Perceptron) ไม่มีความสามารถในการแก้ไขปัญหาที่ไม่เป็นเส้นตรง (Non-linearly Separable) เช่น การทำงานตรรกะ XOR ซึ่งข้อมูลในโลกแห่งความจริงส่วนใหญ่เป็นแบบไม่เป็นเส้นตรง ส่งผลให้งานวิจัยด้านใยประสาทถูกมองว่าไร้อนาคต เงินทุนสนับสนุนจากหน่วยงานรัฐถูกตัดขาด และนำเข้าสู่ช่วงเวลาอันแสนมืดมนของ “The First AI Winter”
💡 3. การฟื้นฟูของใยประสาทและกลไกสะท้อนกลับ (1980s)
- 1986 - การกลับมาอย่างเกรียงไกรของ Backpropagation: ความมืดมิดสิ้นสุดลงเมื่อกลุ่มนักวิจัยนำโดย David Rumelhart, Geoffrey Hinton และ Ronald Williams ตีพิมพ์บทความลงวารสาร Nature แสดงวิธีใช้ตัวแปลงข้อผิดพลาดย้อนกลับหรือ Backpropagation (Backprop) ในการฝึกฝนโครงข่ายประสาทหลายชั้นเลเยอร์ (Multilayer Perceptrons: MLP) ได้สำเร็จ Backprop อาศัยหลักเกณฑ์ลูกโซ่ (Chain Rule) ในการส่งผ่านค่าความผิดพลาดจากฝั่งคำตอบย้อนกลับไปปรับแต่งพารามิเตอร์ด้านในโมเดล ทำให้ข้ามผ่านขีดจำกัด XOR ของมินสกีได้อย่างสมบูรณ์แบบ!
- 1989 - กำเนิด LeNet และการอ่านเช็คธนาคาร: ยานน์ เลอกัน ที่ Bell Labs ได้ผสานรวมเอาแนวคิดสถาปัตยกรรมการมองเห็นแบบระดับชั้นเลเยอร์อย่าง Neocognitron ของ Fukushima (1979/1980) มาร่วมกับ Backpropagation สร้างเป็นโมเดล Convolutional Neural Network (CNN) ในชื่อ LeNet-5 ซึ่งใช้ดึงพิกเซลภาพอ่านลายมือของรหัสไปรษณีย์และตัวเลขบนเช็คของที่ทำการไปรษณีย์สหรัฐฯ ได้อย่างแม่นยำ
📈 4. ยุคเปลี่ยนผ่านสู่โลกสถิติและชัยชนะของโมเดลคลาสสิก (1990s - 2000s)
- จากกฎเกณฑ์สู่ดาต้า (Knowledge-Driven to Data-Driven): ในช่วงปี 1990 วงการ ML ได้แยกตัวเองออกจาก symbolic AI และก้าวเข้าสู่ “ยุคทองแห่งสถิติศาสตร์และการเรียนรู้เชิงคณิตศาสตร์อย่างเป็นระบบ” (Statistical Learning Theory)
- 1995 - พลังทำลายล้างของ Support Vector Machine (SVM): Vladimir Vapnik และ Corinna Cortes นำเสนอ SVM และเทคนิค Kernel Trick ที่สามารถม้วนกระดาษแผนผังข้อมูลที่ปะปนกันแบบไม่เป็นเส้นตรง มิติสูงๆ ให้แยกออกจากกันด้วยระนาบ Hyperplane ได้อย่างเรียบง่ายและเป็นระบบคณิตศาสตร์ที่งดงาม SVM กลายเป็นราชันผู้ครองความนิยมในยุคนั้นและทำให้ Neural Network ที่เทรนช้าและคำนวณยากถูกละเลยไปอีกรอบ
- Ensemble Methods (การผนึกกำลังสมองย่อย): เกิดการพัฒนาเทคนิคผสมผสานโมเดลย่อยๆ ให้มีความทนทานสูง เช่น อัลกอริทึม AdaBoost (1995) และ Random Forests (1995/2001) ซึ่งได้รับความนิยมสูงสุดสำหรับการวิเคราะห์ข้อมูลแบบตารางมาจนถึงปัจจุบัน
🚀 5. มวลมหาข้อมูลและคลื่นปฏิวัติปัญญาประดิษฐ์ (2010s)
- การรวมตัวกันของ 3 ปัจจัยทองคำ ได้แก่ การมาถึงของอินเทอร์เน็ตและ Big Data, การประมวลผลความเร็วสูงด้วย CPU/GPU และ ชุดข้อมูลทดสอบมาตรฐานสากลขนาดใหญ่อย่าง ImageNet (2009)
- 2012 - ประจักษ์พยานแห่งศักดาของ AlexNet: ในการแข่งขันสากลระดับโลก ImageNet อัลกอริทึม Deep CNN ชื่อ AlexNet (พัฒนาโดยทีมวิจัยของ Geoffrey Hinton) สามารถลดอัตราความเอเรอร์ในการจัดหมวดหมู่รูปภาพลงเหลือเพียง 16% ทิ้งห่างโมเดลสถิติคลาสสิกตัวอื่นๆ แบบไม่เห็นฝุ่น ชัยชนะครั้งนี้สั่นสะเทือนวงการและเป็นจุดเปลี่ยนผ่านอย่างเป็นทางการของการเปิดฉากสู่ยุค “Deep Learning Revolution” ที่เราอยู่กันในทุกวันนี้ครับ!
🛠️ ขั้นตอนการทดลองและติดตั้ง (Implementation Guide)
เพื่อเชื่อมโยงความรู้สู่เวิร์กช็อปจริง เรามาดูตัวอย่างประวัติศาสตร์หน้าแรกด้วยโค้ด Python ในการเขียนจำลอง “McCulloch-Pitts Neuron (1943)” โมเดลเซลล์ประสาทเทียมตัวแรกของมนุษยชาติ กันครับ:
import numpy as np
# 1. นิยามคลาสสิกของ McCulloch-Pitts Neuron
def mcculloch_pitts_neuron(inputs, weights, threshold):
"""
สูตรคณิตศาสตร์แบบดั้งเดิม: รวมสัญญาณอินพุตแบบถ่วงน้ำหนัก
หากเกินค่าพิกัด (Threshold) นิวรอนจะส่งสัญญาณ 1 ออกมา (Fires!)
"""
# คำนวณหาค่าผลรวมถ่วงน้ำหนัก (Weighted Sum)
weighted_sum = np.dot(inputs, weights)
# Heaviside Activation Function (ส่งกลับค่าแบบตรรกศาสตร์ 0 หรือ 1)
if weighted_sum >= threshold:
return 1
else:
return 0
# 2. จำลองการทำงานของลอจิกประตูสัญญาณ "AND Gate"
# [Input 1, Input 2] ครบทุกกรณี 00, 01, 10, 11
and_inputs = np.array([[0, 0], [0, 1], [1, 0], [1, 1]])
# กำหนดค่าน้ำหนักคงที่ (Fixed Weights) และเกณฑ์การตัดสินใจ (Threshold)
weights = np.array([1, 1]) # กำหนดน้ำหนักขาละ 1
threshold = 2 # ต้องรวมได้ 2 ถึงจะส่งค่า 1 (เป็นจริงเฉพาะกรณี 1 AND 1)
print("--- ผลลัพธ์จำลองการทำงานของ McCulloch-Pitts Neuron สำหรับ AND Gate ---")
for inputs in and_inputs:
result = mcculloch_pitts_neuron(inputs, weights, threshold)
print(f"Inputs: {inputs} | Weighted Sum: {np.dot(inputs, weights)} | Output: {result}")⚠️ ข้อควรระวังและแนวทางปฏิบัติที่ดีที่สุด (Pitfalls & Best Practices)
The Lesson of AI Winters (บทเรียนราคาแพงจากยุคหนาวเหน็บ): ประวัติศาสตร์สอนเราว่า ยุคมืดของ AI เกิดขึ้นจาก “การสร้างสภาวะโฆษณาที่เกินความจริงและความสามารถจริงของระบบ” (Overpromising & Hype). ดังนั้น ในฐานะวิศวกร ML ยุคใหม่ คุณจำเป็นต้องระมัดระวังเป็นพิเศษในการประเมินประสิทธิภาพของโมเดลอย่างตรงไปตรงมา ไม่มองเทคโนโลยีเป็นเรื่องเวทมนตร์ และออกแบบกลไกทดสอบ (Test/Validation Splits) ที่น่าเชื่อถือ เพื่อไม่ให้ประวัติศาสตร์ความผิดพลาดกลับมาซ้ำรอยครับ.
Respect the “No Free Lunch” Theorem: ไม่มีโมเดลเดียวที่ดีที่สุดสำหรับทุกโจทย์ปัญหาในอุตสาหกรรม! อัลกอริทึมที่คว้าแชมป์ในอดีตอย่าง SVM, Random Forest หรือ Decision Tree ยังคงเป็นอาวุธระดับพรีเมียมที่รวดเร็วและใช้หน่วยความจำน้อยกว่าสำหรับการประมวลผลข้อมูลแบบตาราง เมื่อเทียบกับโมเดล Deep Learning โครงสร้างใหญ่ครับ.
📝 บทสรุปและสเกลถัดไป (Conclusion & Next Steps)
จากอารยธรรมหลอดสูญญากาศและระบบสถิติก้าวข้ามอุปสรรค XOR ผ่านกลไกสะท้อนกลับ Backpropagation มาจนถึงวันที่ GPU ปลดปล่อยพันธนาการให้แก่อัลกอริทึมใยประสาท ประวัติศาสตร์ของ Machine Learning ได้พิสูจน์ให้เห็นแล้วว่า ความสำเร็จไม่ได้ขึ้นอยู่กับการออกแบบคำสั่งที่สมบูรณ์แบบโดยมนุษย์ แต่เกิดจากการมอบความสามารถให้ระบบ “เรียนรู้และขยับปรับตัว” ไปตามข้อมูลจริงบนรากฐานสถิติ.
คำถามถัดไปที่น่าคิดคือ… เมื่อโครงข่ายประสาทเทียมถูกคิดค้นขึ้นมาตั้งแต่ยุค 1980s แล้วทำไมจู่ๆ เทคโนโลยีที่เคยพังทลายอย่าง Deep Learning ถึงกลับมาผงาดและปฏิวัติโลกเทคโนโลยีได้อย่างรวดเร็วในทศวรรษนี้?
เราจะมาเจาะลึกความลับและสางปมปริศนานี้ไปด้วยกันในบทความวิชาการตอนหน้า: “ตอนที่ 6: ทำไม Deep Learning ถึงได้รับความนิยมในปัจจุบัน? — ขุดคุ้ย 3 พลังวิเศษเบื้องหลังสถาปัตยกรรมปฏิวัติเทคโนโลยี” เตรียมตัวปักหมุดรออ่านกันได้เลยครับ!