ตอนที่ 9: Features และ Labels คืออะไร? — เปิดความลับพิกัดตัวแปรและคำทำนายในโลกสถิติเรียนรู้
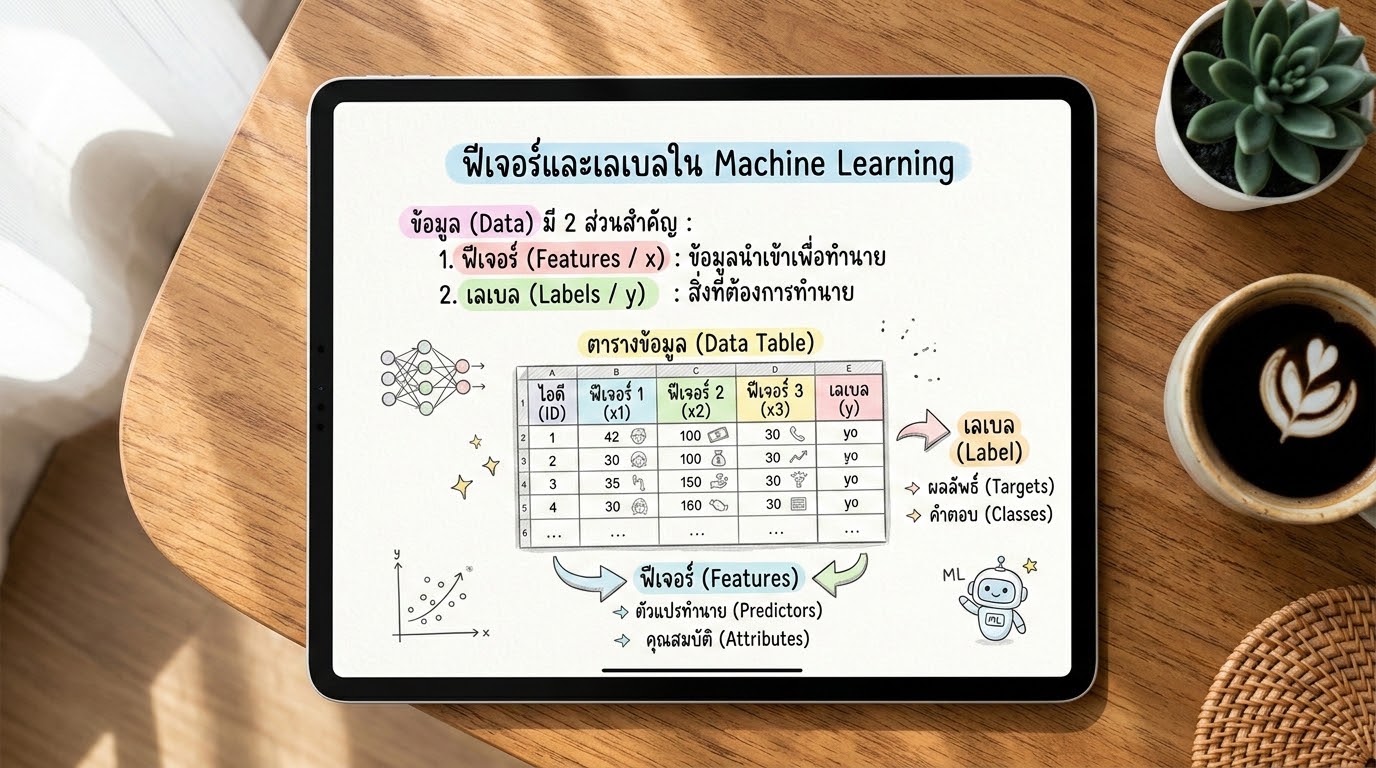
ลองจินตนาการว่าคุณเป็นแพทย์ผู้เชี่ยวชาญในโรงพยาบาลอัจฉริยะ วันนี้มีผู้ป่วยเดินเข้ามาหาคุณด้วยอาการไข้ขึ้นสูง ไอแห้ง และมีน้ำมูกไหล สมองของคุณจะทำการสแกนประเมินอาการเหล่านี้ในทันที จากนั้นคุณจึงสรุปผลการวินิจฉัยว่า "ผู้ป่วยรายนี้เป็นไข้หวัดใหญ่"
ในกระบวนการนี้ อาการทางฟิสิกส์ที่เราวัดได้จากร่างกายผู้ป่วย (ไข้สูง, ไอ, น้ำมูกไหล) แท้จริงแล้วก็คือสิ่งที่เราใช้สังเกตเพื่อจับทิศทางหาความเชื่อมโยง และข้อสรุปทางการแพทย์ (ไข้หวัดใหญ่) ก็คือผลลัพธ์ปลายทางของการคาดเดา
เมื่อเราแปลงกระบวนการตัดสินใจนี้ให้อยู่ในหน้าต่างวิศวกรรมปัญญาประดิษฐ์ อาการทางร่างกายเหล่านั้นจะถูกเรียกว่า Features (คุณลักษณะ) และผลลัพธ์การวินิจฉัยจะถูกเรียกว่า Labels (ป้ายเฉลย/เป้าหมาย) ซึ่งเป็นคำศัพท์ฐานรากที่ทรงคุณค่าที่สุดของการเรียนรู้แบบมีผู้สอน (Supervised Learning) วันนี้พี่วิศวกร AI จะพามาสแกนแก่นแท้ของสองคำนี้เพื่อปูทางไปสู่โครงสร้างข้อมูลของ Obsidian และ Hugo กันครับ!
🧠 ทฤษฎีและหลักการเบื้องหลัง (Theoretical Framework)
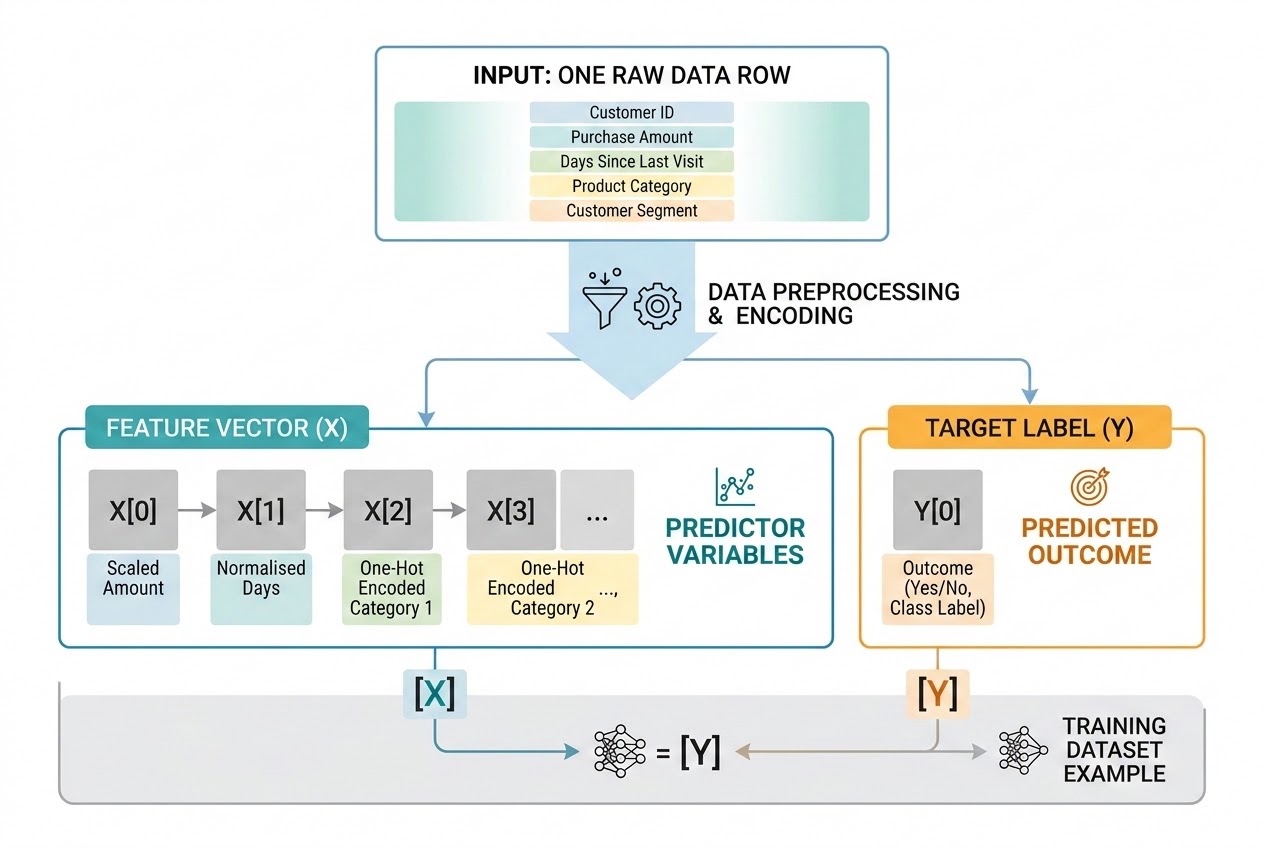
ในกรอบงานคณิตศาสตร์สถิติและการเรียนรู้ของเครื่องข้อมูลดิบหนึ่งรายการหรือหนึ่งแถวในตารางข้อมูล (Instance/Sample) จะถูกมองเป็นคู่ลำดับความสัมพันธ์:
$$ (\mathbf{x}, y) $$
1. Features (คุณลักษณะ/ตัวแปรต้น)
- นิยามเชิงลึก: Features คือตัวแปรอิสระ (Independent Variables) หรือคุณสมบัติเฉพาะตัวที่เราใช้ตรวจวัด สังเกต และป้อนเข้าไปให้โมเดลเพื่อใช้ในการประมวลผลวิเคราะห์หาความเชื่อมโยง
- สัญลักษณ์ทางคณิตศาสตร์: โดยทั่วไปจะใช้สัญลักษณ์เวกเตอร์ตัวหนาตัวพิมพ์เล็ก $\mathbf{x}$ ซึ่งประกอบด้วยฟีเจอร์ย่อยหลายตัวแปร (เรียกว่า Feature Vector) ขนาด $d$ มิติ:
$$ \mathbf{x} = \begin{bmatrix} x_1 \ x_2 \ \vdots \ x_d \end{bmatrix} \in \mathbb{R}^d $$
- ตัวอย่างหน้างานอุตสาหกรรม: หากเราต้องการให้ระบบตรวจสอบรอยร้าวบนแผ่นกระจก ค่าฟีเจอร์ $\mathbf{x}$ อาจประกอบไปด้วย:
- $x_1$: ค่าระดับความสว่างพิกเซล (Average Pixel Intensity)
- $x_2$: ดัชนีการสะท้อนแสง (Reflectance Index)
- $x_3$: ความหนาของแผ่นกระจก (มม.)
2. Labels (ป้ายเฉลย/ตัวแปรตาม)
- นิยามเชิงลึก: Labels คือตัวแปรตาม (Dependent Variable) หรือผลลัพธ์เป้าหมายสูงสุดที่เราอยากให้คอมพิวเตอร์ทำนายได้เองอย่างถูกต้องเมื่อมีฟีเจอร์ใหม่ป้อนเข้ามา
- สัญลักษณ์ทางคณิตศาสตร์: มักแทนด้วยสัญลักษณ์ตัวพิมพ์เล็ก $y$
- หาก $y$ เป็นกลุ่มหมวดหมู่ที่ไม่ต่อเนื่อง เช่น $y \in {0, 1}$ (0 = ชิ้นงานปกติ, 1 = ชิ้นงานชำรุด) จะเรียกว่างาน Classification (การจำแนกประเภท)
- หาก $y$ เป็นตัวเลขต่อเนื่อง เช่น $y \in \mathbb{R}$ (ความดันบาร์, เปอร์เซ็นต์ความร้อน) จะเรียกว่างาน Regression (การทำนายค่าต่อเนื่อง)
- การมีอยู่ของ Label: พึงระลึกไว้เสมอว่าข้อมูลที่มี Label เฉลยติดมาด้วยนั้น เป็นวัตถุดิบหลักจำเพาะสำหรับ Supervised Learning เท่านั้น หากเรานำข้อมูลดิบไปรันระบบจัดกลุ่มแบบไม่มีเฉลย (Unsupervised Clustering) ข้อมูลนั้นจะมีเพียงแต่ฟีเจอร์ $\mathbf{x}$ ปราศจากป้ายเฉลย $y$ ครับ
Senior AI Brother’s Analogy: เปรียบระบบตรวจจับแอปเปิลเน่าในสายพานผลิต:
- Features คือ "หลักฐานทางนิติวิทยาศาสตร์" เช่น น้ำหนักของแอปเปิล, เปอร์เซ็นต์รอยคล้ำดำบนเปลือก และกลิ่นแก็สเอทิลีนที่โชยออกมา
- Labels คือ "คำพิพากษาของศาล" ว่าผลนี้จะถูกจัดลงตะกร้า "ผ่านเกณฑ์คุณภาพ" หรือ "โยนทิ้งลงถังขยะ"
The Target Leakage Trap (หลุมพรางข้อมูลเป้าหมายรั่วไหล): ระวังภัยร้ายแรงที่สุดในวิศวกรรมข้อมูลที่เรียกว่า Data/Target Leakage ครับ! มันคือสภาวะที่เราเผลอนำเอาข้อมูลที่ "มีความเชื่อมโยงโดยตรงหรือเกิดขึ้นหลังจากป้ายเฉลยถูกกำหนดแล้ว" ไปป้อนเป็นฟีเจอร์ให้โมเดลตอนฝึกสอน เช่น เผลอใส่คอลัมน์ "รหัสประวัติการเคลมประกันชิ้นงานเสีย" เข้าไปเป็นฟีเจอร์สอนโมเดลทำนายชิ้นงานชำรุด โมเดลจะสอบได้คะแนนเต็ม 100% ตอนทดสอบ แต่เมื่อนำไปใช้ Deploy ตรวจจับภาพแอปเปิลดิบหน้างานจริง โมเดลจะทายพลาดทั้งหมดเพราะในสายพานจริงยังไม่มีใครทำเรื่องเคลมประกัน!
🛠️ ขั้นตอนการทดลองและติดตั้ง (Implementation Guide)
เพื่อให้น้องๆ สามารถนำโน้ตโครงสร้างคณิตศาสตร์นี้ไปประยุกต์และคัดลอกลงในระบบ Obsidian หรือรันเวิร์กช็อปร่วมกับ Pandas ได้ทันที พี่ได้จัดเตรียมสคริปต์สกัดแยกคอลัมน์ฟีเจอร์และเลเบลจากฐานข้อมูลอุตสาหกรรมจำลองดังนี้ครับ:
import numpy as np
import pandas as pd
# =====================================================================
# 1. จำลองตารางประวัติศาสตร์คุณภาพสายผลิต (Raw Industrial Dataset)
# =====================================================================
data_table = {
# [Features - ตัวแปรต้นที่ใช้สแกน]
'Vibration_Rate': [1.2, 1.5, 4.8, 1.1, 5.2, 1.4], # ค่าการสั่นสะเทือนเครื่องจักร
'Acoustic_Decibel': [45.0, 48.0, 82.0, 43.0, 89.0, 46.0], # ค่าเสียงรบกวน (dB)
# [Label - เฉลยผลลัพธ์คำตัดสินใจปลายทาง]
'Machine_Failure': [0, 0, 1, 0, 1, 0] # 0 = ปกติ, 1 = พังชำรุด
}
# แปลงเป็นตาราง DataFrame มาตรฐานสากล
df = pd.DataFrame(data_table)
print("--- 1. ตารางข้อมูลดิบ (Structured Raw Dataset) ---")
print(df)
# =====================================================================
# 2. กระบวนการแยก Features (X) และ Labels (y) เชิงวิศวกรรม
# =====================================================================
# สกัดเอาเฉพาะคอลัมน์ที่เป็น Features เพื่อทำหน้าที่เป็น Matrix X
# โดยการ Drop คอลัมน์เฉลยทิ้งไป
X = df.drop(columns=['Machine_Failure'])
# สกัดเฉพาะคอลัมน์ปลายทางมาเป็นเวกเตอร์เป้าหมาย y
y = df['Machine_Failure']
# =====================================================================
# 🔍 แสดงพิกัดข้อมูลที่พร้อมส่งถ่ายเข้าสู่กระบวนการ Train
# =====================================================================
print("\n--- 2. ส่วนของ Features Matrix (X) ---")
print(X)
print(f"มิติของ X (Shape): {X.shape} -> [6 ชิ้นงาน, 2 ฟีเจอร์ย่อย]")
print("\n--- 3. ส่วนของ Target Label (y) ---")
print(y.to_numpy())
print(f"มิติของ y (Shape): {y.shape} -> [6 ป้ายเฉลย]")📝 บทสรุปและสเกลถัดไป (Conclusion & Next Steps)
การจำแนกและจัดระเบียบโครงสร้าง Features (ตัวแปรต้นเหตุ) และ Labels (ตัวแปรคำตอบ) คือกุญแจดอกสำคัญในการเปลี่ยนผ่านจากข้อมูลดิบที่ไร้ระเบียบให้กลายเป็นแผนผังโจทย์คณิตศาสตร์ที่สอดรับกับสมองกล หากเราปูเสาหลักข้อมูลดิบสองฝั่งนี้อย่างชัดเจนและปราศจากจุดรั่วไหล โมเดลของเราก็จะเรียนรู้เพื่อหาทับซ้อนความชันได้อย่างเฉียบคมและแม่นยำที่สุดครับ
แต่หลังจากที่เราคัดสรรพิกัด Features และมีป้ายเฉลย Labels ที่ถูกต้องครบถ้วนแล้ว คำถามถัดไปที่วิศวกรปัญญาประดิษฐ์ต้องตอบให้ได้คือ… "เราควรเอาชุดข้อมูลที่มีค่ายิ่งยวดนี้ทั้งหมดไปป้อนให้โมเดลท่องจำรวดเดียวเลยหรือไม่? และเราจะรู้ได้อย่างไรว่าโมเดลที่เราสอบผ่านในห้องแล็บจะไปทำงานจริงได้โดยไม่พังพินาศ?"
เตรียมตัวทบทวนและติดตามอ่านกันต่อในบทความตอนถัดไป: "ตอนที่ 10: Training vs. Testing — ศิลปะการแยกแยะข้อมูลฝึกสอนและชุดข้อสอบเพื่อคุมเสถียรภาพสมองกล" คอยตรวจเช็คคีย์เวิร์ดล่วงหน้ากันได้เลยครับวิศวกรรุ่นน้อง!