ตอนที่ 1: จุดเริ่มต้นของปัญญาประดิษฐ์ — ถอดรหัสความต่างโปรแกรมยุคเก่า VS พลังแห่งการเรียนรู้ผ่านข้อมูล
ลองจินตนาการว่าคุณเป็นวิศวกรระบบวิชัน (Vision Engineer) ในโรงงานคัดแยกผลไม้อัตโนมัติ วันดีคืนดีผู้บริหารเดินมาสั่งว่า “ช่วยเขียนโปรแกรมคัดแยกแอปเปิลเกรดพรีเมียมออกจากตารางผลิตที!”
หากคุณใช้วิธีการเขียนโค้ดแบบเดิม คุณคงต้องเริ่มตั้งกล้อง ถ่ายรูป และเริ่มกำหนดกติกา เช่น หากแอปเปิลมีน้ำหนักมากกว่า 120 กรัม และมีค่าความสว่างของสีแดงเกิน 70% ให้ระบุเป็นคลาสพรีเมียม แต่ในความเป็นจริงหน้างานนั้นโหดร้ายกว่านั้นเยอะครับ แสงสะท้อนในโรงงานเปลี่ยนไปตามช่วงเวลาของวัน แอปเปิลมีสายพันธุ์ใหม่ๆ ที่สีสันอมเหลืองอมเขียวปนเข้ามา โปรแกรมของคุณเริ่มตอบผิดพลาดจนสายพานปั่นป่วน คุณต้องกลับมานั่งแก้เงื่อนไข nested IF-ELSE ซับซ้อนซ่อนเงื่อนจนแทบไม่ได้หลับไม่ได้นอน
นี่คือ Pain Point คลาสสิกที่อุตสาหกรรมเผชิญ และเป็นเหตุผลว่าทำไมเราจึงต้องทำความเข้าใจการเปลี่ยนผ่านพาราดามจากคอมพิวเตอร์เขียนกฎ สู่ยุคสมัยที่ “คอมพิวเตอร์สร้างกฎเรียนรู้จากข้อมูลเอง” ครับ
🧠 ทฤษฎีและหลักการเบื้องหลัง (Theoretical Framework)
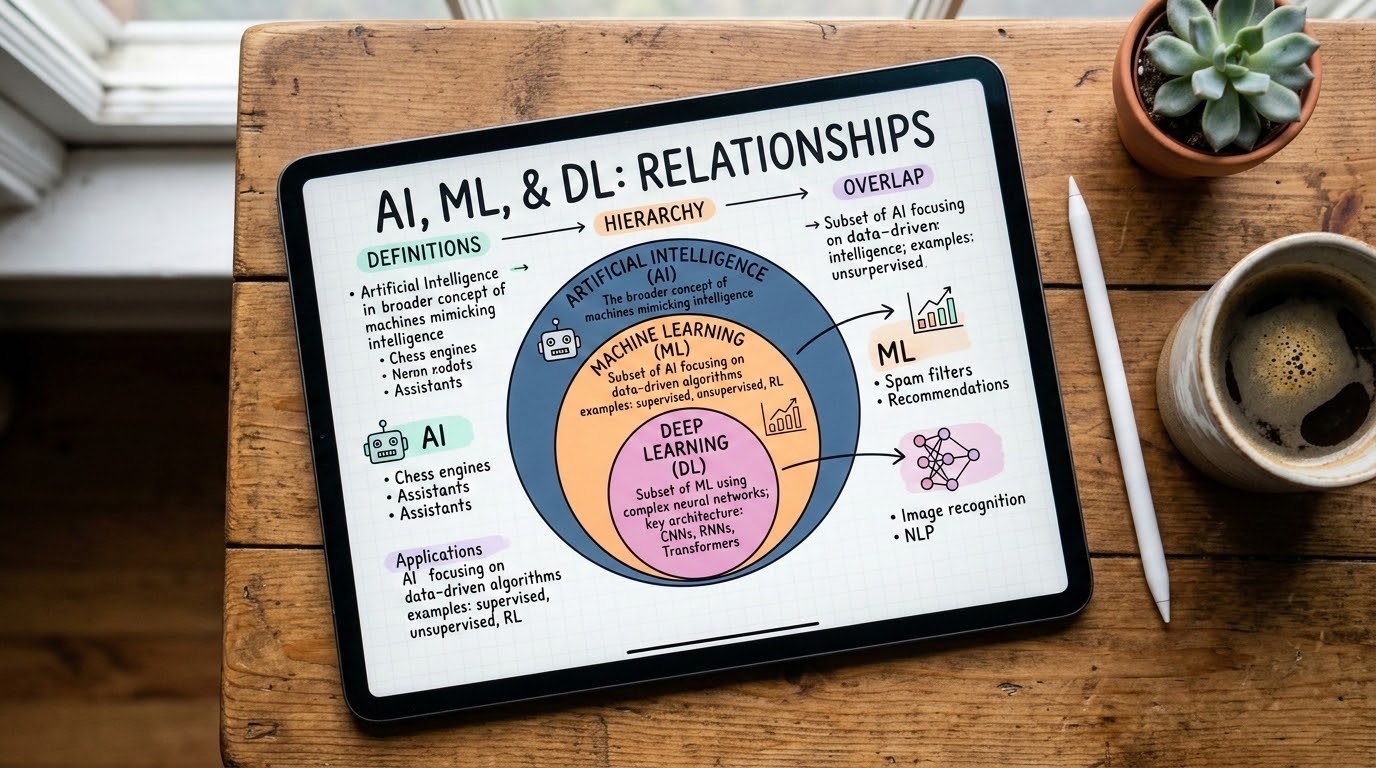
ในปฐมบทของเส้นทางสาย AI นี้ เราจำเป็นต้องแยกแยะพี่น้องทั้ง 3 ของตระกูลปัญญาประดิษฐ์ให้ออกจากกันอย่างเด็ดขาด เพื่อความเข้าใจที่ถูกต้องเชิงวิศวกรรมระบบครับ:
┌─────────────────────────────────────────┐
│ Artificial Intelligence (AI) │
│ ┌───────────────────────────────┐ │
│ │ Machine Learning (ML) │ │
│ │ ┌─────────────────────────┐ │ │
│ │ │ Deep Learning (DL) │ │ │
│ │ └─────────────────────────┘ │ │
│ └───────────────────────────────┘ │
└─────────────────────────────────────────┘1. ถอดรหัสคำศัพท์ 3 คำสำคัญ (AI, ML, DL):
- Artificial Intelligence (AI) - ปัญญาประดิษฐ์: คือ ร่มใหญ่ที่สุดของวงการวิทยาศาสตร์คอมพิวเตอร์ ครอบคลุม “ทุกความพยายาม” ในการสร้างเทคโนโลยี, อัลกอริทึม หรือโค้ดโปรแกรมที่สามารถเลียนแบบพฤติกรรม สติปัญญา การคิดวิเคราะห์ หรือการตัดสินใจของสิ่งมีชีวิตและมนุษย์ได้ โดยระบบ AI ในอดีตอาจจะไม่ได้มีความสามารถในการเรียนรู้ด้วยตนเองเลยก็ได้ เช่น ระบบผู้เชี่ยวชาญ (Expert Systems) หรือบอทหมากรุกยุคเก่าที่ใช้การเขียนโปรแกรมทางตรรกศาสตร์แข็งตัว (Hardcoded Rules)
- Machine Learning (ML) - การเรียนรู้ของเครื่อง: คือ ซับเซตที่เติบโตและได้รับความนิยมสูงที่สุดภายใต้ร่มเงาของ AI มันคือศาสตร์ของการสร้างอัลกอริทึมและแบบจำลองทางสถิติที่ช่วยให้ระบบคอมพิวเตอร์สามารถ “เรียนรู้และพัฒนาทักษะได้เองผ่านประสบการณ์และข้อมูลดิบ” โดยปราศจากการเขียนคำสั่งควบคุมหรือกำหนดกฎเกณฑ์ล่วงหน้าอย่างตรงไปตรงมาโดยมนุษย์
- Deep Learning (DL) - การเรียนรู้เชิงลึก: เป็นซับเซตเฉพาะทางระดับแอดวานซ์ที่แตกแขนงออกมาจาก Machine Learning อีกทีหนึ่ง โดยมีโครงสร้างหลักที่หยิบยืมแรงบันดาลใจมาจากเครือข่ายใยประสาทในสมองของมนุษย์ (Biological Neurons) ที่เรียกว่า โครงข่ายประสาทเทียมหลายชั้น (Deep Artificial Neural Networks: ANNs) โดดเด่นอย่างยิ่งในการจัดการข้อมูลที่ไม่มีโครงสร้างชัดเจน (Unstructured Data) เช่น เสียง รูปภาพ วิดีโอ หรือข้อความขนาดใหญ่
Senior AI Brother’s Analogy:
- เปรียบ AI เป็นดั่ง “อารยธรรมวิศวกรรม” ที่ต้องการสร้างหุ่นยนต์ขึ้นมาเลียนแบบสิ่งมีชีวิต
- เปรียบ ML เป็นดั่ง “นักเรียนสายขยัน” ที่ชอบทบทวนชุดข้อสอบเก่าพร้อมเฉลย (Historical Labeled Data) จนสามารถจับทางข้อสอบจริงที่จะออกในห้องเรียนรอบถัดไปได้ด้วยตัวเอง
- เปรียบ DL เป็นดั่ง “ทารกน้อยผู้เรียนรู้โลก” ค่อยๆ ใช้ประสาทสัมผัสซับซ้อนหลายระดับในการมองเห็น แยกลักษณะโครงสร้างจากความมืด ความสว่าง ลวดลาย ไปสู่รูปร่างของสิ่งของต่างๆ ได้เองอัตโนมัติโดยไม่มีใครต้องไปจัดโครงสร้างข้อมูลให้ล่วงหน้า
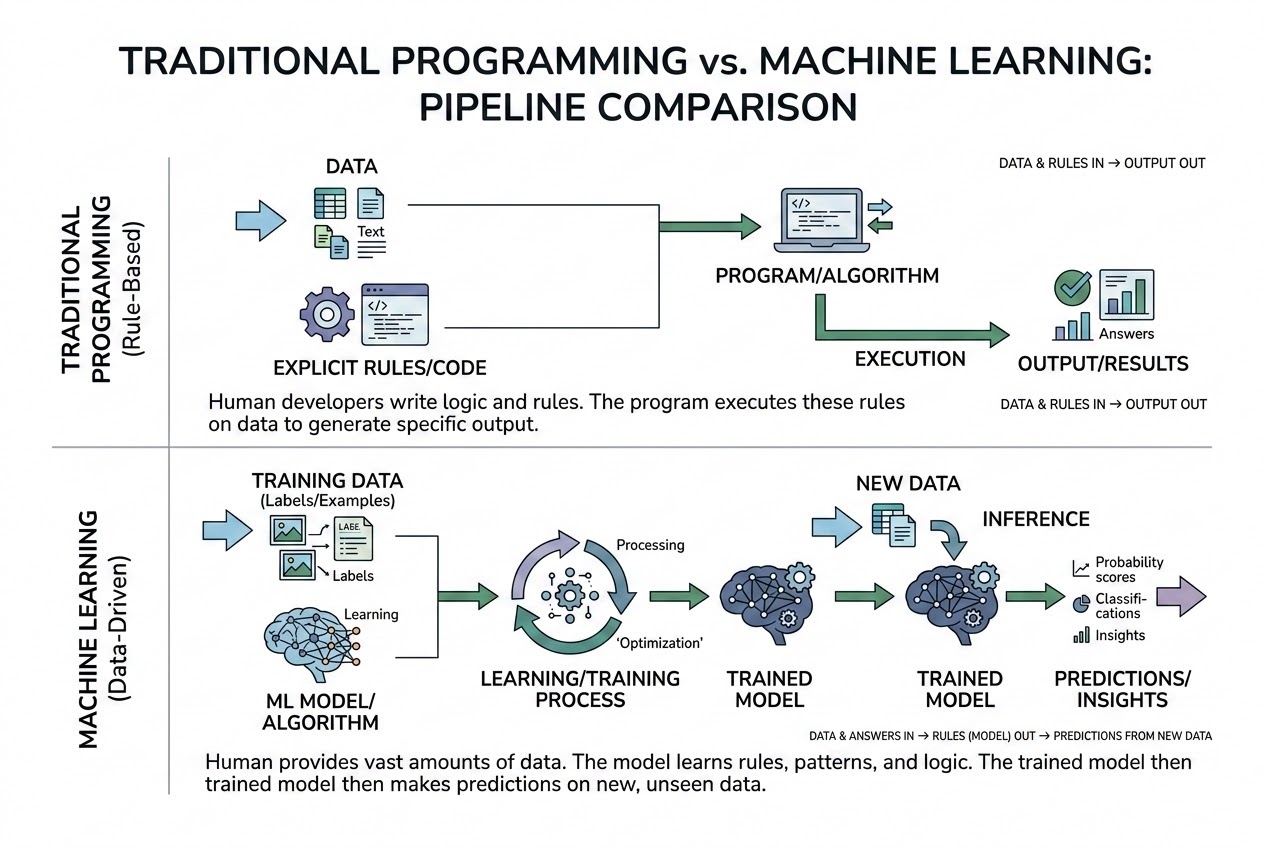
2. การเปรียบเทียบระบบ: Traditional Programming VS Machine Learning
เพื่อให้นักพัฒนามองเห็นกระบวนการทำงานที่กลับแกนไปโดยสิ้นเชิง ลองดูตารางเปรียบเทียบและ Bullet points ชี้ประเด็นสำคัญด้านล่างนี้ครับ:
- Traditional Programming (โปรแกรมมิ่งแบบดั้งเดิม):
- ทิศทางข้อมูล: มนุษย์ต้องป้อน “ข้อมูลดิบ (Input/Data)” ควบคู่ไปกับ “กฎเกณฑ์ที่โปรแกรมเมอร์คิดค้นขึ้นมาเอง (Rules/Code)” เข้าไปในคอมพิวเตอร์ เพื่อรันโปรแกรมและรับ “ผลลัพธ์/คำตอบ (Output/Answers)”
- ข้อจำกัด: หากเจอปัญหาที่มีปัจจัยหน้างานเปลี่ยนแปลงตลอดเวลา หรือมีความซับซ้อนในการเขียนเงื่อนไขมากเกินไป เช่น การจดจำใบหน้ามนุษย์ หรือการคัดแยกประเภทความเสียหายบนพื้นผิวเหล็ก โค้ดจะใหญ่และซับซ้อนจนไม่สามารถดูแลรักษาหรือรันได้จริงในระยะยาว
- Machine Learning (การเรียนรู้ของเครื่อง):
- ทิศทางข้อมูล: เราทำการสลับแกนครับ! มนุษย์จะส่ง “ข้อมูลดิบ (Data)” พร้อมกับ “ผลลัพธ์ปลายทางที่ถูกต้อง (Answers/Labels)” เข้าสู่คอมพิวเตอร์พร้อมกัน เพื่อให้อัลกอริทึมประมวลผลจับทิศทางและสร้าง “กฎเกณฑ์หรือโมเดล (Rules/Model)” ขึ้นมาใช้งานเองโดยอัตโนมัติ
- จุดเด่น: ระบบมีความยืดหยุ่นสูง (Adaptivity) สามารถปรับจูนพารามิเตอร์น้ำหนักการคำนวณด้านในของตนเองเพื่อให้ตอบคำถามได้ถูกต้องยิ่งขึ้นเมื่อมีปริมาณชุดข้อมูลป้อนเข้ามาเพิ่มขึ้นเรื่อยๆ โดยที่วิศวกรไม่ต้องกลับมาแก้โค้ดแกนหลักแม้แต่บรรทัดเดียว
🛠️ ขั้นตอนการทดลองและติดตั้ง (Implementation Guide)
เพื่อความเป็นวิศวกร AI ตัวจริง เราจะมาทดลองเขียนโค้ดเปรียบเทียบแนวคิดคลาสสิกนี้ให้เห็นประจักษ์คาตา ด้วยภาษา Python และไลบรารี Scikit-learn กันครับ:
import numpy as np
from sklearn.linear_model import LogisticRegression
# =====================================================================
# วิธีที่ 1: Traditional Rule-Based (โปรแกรมมิ่งแบบใช้กฎที่มนุษย์สร้างเอง)
# =====================================================================
def traditional_apple_grader(weight, redness_score):
"""
มนุษย์สร้างกฎ (Rules) ขึ้นมาควบคุมการตัดสินใจอย่างคงตัว
"""
if weight > 120 and redness_score > 0.7:
return 1 # คัดเป็นระดับ "Premium"
else:
return 0 # คัดเป็นระดับ "Regular"
# ทดสอบรันโปรแกรมแบบปกติ
print("--- Traditional Programming Result ---")
# ส่งข้อมูลแอปเปิลผลใหม่: น้ำหนัก 125 กรัม, แดง 0.72
print(f"Result: {traditional_apple_grader(125, 0.72)}")
# =====================================================================
# วิธีที่ 2: Machine Learning Approach (ให้คอมพิวเตอร์ค้นหากฎจากข้อมูลเอง)
# =====================================================================
# 1. เตรียมประวัติข้อมูลในอดีต (Data)
# คุณลักษณะ (Features): [น้ำหนัก (กรัม), ค่าสัดส่วนสีแดง (0.0 - 1.0)]
X_historical_data = np.array([
[150, 0.85], # ผลที่ 1
[130, 0.75], # ผลที่ 2
[90, 0.40], # ผลที่ 3
[110, 0.30], # ผลที่ 4
[140, 0.90], # ผลที่ 5
[85, 0.20] # ผลที่ 6
])
# เฉลยเกรดแอปเปิลจริงจากตาผู้เชี่ยวชาญ (Answers/Labels)
y_true_labels = np.array([1, 1, 0, 0, 1, 0]) # 1 = Premium, 0 = Regular
# 2. คอมพิวเตอร์ทำการ "เรียนรู้" (Training Phase) เพื่อสร้างกฎขึ้นมาเอง
# เราเลือกใช้โมเดลแบ่งกลุ่ม Logistic Regression จาก Scikit-learn
clf_model = LogisticRegression()
clf_model.fit(X_historical_data, y_true_labels) # ปล่อยให้อัลกอริทึมค้นหากฎเกณฑ์ภายใน (Weights)
# 3. นำกฎที่เรียนรู้ได้เองไปทำนายกับข้อมูลแอปเปิลผลใหม่ (Inference Phase)
new_test_apple = np.array([[125, 0.72]])
ml_prediction = clf_model.predict(new_test_apple)
print("\n--- Machine Learning Programming Result ---")
print(f"ML Model Predict: {ml_prediction} (0 = Regular, 1 = Premium)")⚠️ ข้อควรระวังและแนวทางปฏิบัติที่ดีที่สุด (Pitfalls & Best Practices)
The Bad Data Trap: โปรดจำไว้เสมอว่าระบบ Machine Learning มีพฤติกรรมเรียนรู้ตามข้อมูลที่ป้อนเข้าไป หากชุดข้อมูลเริ่มต้นของคุณมีอคติ (Bias) หรือข้อมูลขยะปะปนอยู่มาก เช่น แอปเปิลพรีเมียมทั้งหมดถูกบันทึกในช่วงที่กล้องขัดข้องจนภาพมัว โมเดลจะไปจดจำว่า “ภาพมัวๆ คือระดับพรีเมียม” ซึ่งจะสร้างความพังพินาศในระบบจริงทันที!
When to NOT use Machine Learning: แม้ว่า ML จะดูเป็นยาครอบจักรวาลในยุคปัญญาประดิษฐ์เฟื่องฟู แต่หากโจทย์ปัญหานั้นสามารถระบุด้วยกฎเชิงตรรกศาสตร์ (Boolean logic) ได้อย่างเด่นชัดและแน่นอน 100% เช่น “การคำนวณอัตราภาษีตามฐานรายได้” หรือ “การรันระบบโปรแกรมคำนวณคณิตศาสตร์ทั่วไป” การใช้โปรแกรมแบบดั้งเดิม (Traditional Programming) จะให้ความถูกต้อง มั่นคง และประหยัดทรัพยากรกว่าหลายสิบเท่าครับ
📝 บทสรุปและสเกลถัดไป (Conclusion & Next Steps)
นี่เป็นเพียงก้าวแรกของการปฏิวัติวงการเทคโนโลยีเท่านั้นครับ จากจุดเริ่มต้นของปัญญาประดิษฐ์ที่พยายามจะถอดรูปแบบสมองมนุษย์ สู่ยุคสมัยที่เรามีเครื่องมือวิเศษอย่าง Scikit-learn และ TensorFlow มาอำนวยความสะดวกในการจัดหาคำตอบให้สอดคล้องกับสภาพแวดล้อมที่คาดเดาไม่ได้
ในตอนหน้า เราจะมาลงรายละเอียดลึกซึ้งยิ่งขึ้นเกี่ยวกับการจัดแจงสางปมปัญหาในข้อมูลดิบเพื่อให้เหมาะสมกับการป้อนเข้าระบบเรียนรู้ในบทความ “ตอนที่ 2: นิยามที่แท้จริงของ Machine Learning” คอยติดตามกันด้วยนะครับ!